Неделя 6. Архитектура, часть I
Учиться в приложении: тьютор, задачи с кодом →
Ядро: residual stream и pre-norm, RMSNorm, SwiGLU и F = 8D/3, нотация B/L/T/S/V/D/H/F/N/K/G · Глубина: weight tying, геометрия RMSNorm (D3) · ≈ 10 ч ядро / 19 ч всё
Каждый элемент современного блока (pre-norm, RMSNorm, SwiGLU) отвечает на конкретную проблему трансформера 2017 года, а не мода. Без понимания, зачем они, не получится отладить обучение глубокой модели (неделя 10) и посчитать её параметры (неделя 9).
Нотация (выучить наизусть, ей пользуются во всех обсуждениях):
B | размер батча |
L | число слоёв |
T | длина генерации |
S | длина контекста |
V | размер словаря |
D | скрытая размерность |
H | размерность головы |
F | скрытая размерность MLP (обычно 4D) |
N | число query-голов, N·H = D |
K | число key/value-голов, K < N в GQA |
G | размер группы GQA = N // K |
Шаг 1. Residual stream и место нормализации
На пальцах. Residual stream это общая тетрадь, которую по очереди получают L авторов. Каждый
не переписывает страницу, а дописывает поправку. В post-norm после каждого автора тетрадь целиком
перепечатывают через фильтр, и сигнал об ошибке идёт к первому автору через все L фильтров.
Каждый фильтр умножает его на свой множитель, и множители перемножаются: при 0.9 на слой
через 32 слоя остаётся 0.9³² ≈ 0.03. В pre-norm
фильтр стоит только на входе автора: он читает нормированную копию, а поправку добавляет к оригиналу.
- Эмбеддинги, residual stream как «шина» модели:
x_{l+1} = x_l + f_l(x_l). Якобиан слоя равенI + ∂f/∂x, у градиента всегда есть путь через единицу (та же идея у LSTM, неделя 19) - Pre-norm vs post-norm, почему все перешли на pre-norm. Post-norm
LN(x + f(x))ставит норму на сам путь градиента: на инициализации градиенты у последних слоёв велики, нужен долгий warmup (разгон learning rate с нуля). Pre-normx + f(LN(x))оставляет путь чистым. Цена: норма потока растёт с глубиной, поздние слои меняют его всё слабее, а перед головой нужна финальная норма
На пальцах. Вектор [3, 4]: среднеквадратичное √((9 + 16)/2) ≈ 3.54. RMSNorm делит на него
и получает [0.85, 1.13]: масштаб стандартный, направление прежнее. LayerNorm сначала вычла бы
среднее 3.5 и получила [−1, 1]: то, что оба числа положительные, потеряно. Опыт показал, что
центрирование почти ничего не даёт, а стоит отдельного прохода по вектору.
- RMSNorm:
x / √(mean(x²) + ε) ⊙ γ. Чем отличается от LayerNorm (нет вычитания среднего и нет bias) и почему это дешевле: одна редукция (свёртка вектора в число) вместо двух. Геометрически (D3): выход RMSNorm лежит на сфере радиуса√D, LayerNorm на такой же сфере внутри гиперплоскости⊥ 𝟏. Обучаемаяγвозвращает модели масштаб по каждому измерению, вплоть до зануления
Шаг 2. FFN с гейтом
На пальцах. Swish (Swish(x) = x·σ(x), где σ сигмоида) это гладкий вариант ReLU: большое положительное число
проходит почти целиком, отрицательное гасится почти до нуля. Пусть F = 2, и для одного токена значение xW₁ = (3, 3),
а гейт xW₂ = (2, −2). Swish гейта: 2·σ(2) ≈ 2·0.88 = 1.76 и −2·σ(−2) ≈ −2·0.12 = −0.24. Поэлементное произведение
(3·1.76, 3·(−0.24)) ≈ (5.28, −0.72): одинаковое значение 3 в первой координате прошло с усилением, во второй почти
закрылось. Потом W₃ возвращает вектор к размеру D. Значение отвечает на вопрос «что передать», гейт на вопрос «сколько».
- SwiGLU FFN:
(xW₁) ⊙ Swish(xW₂), затемW₃. Три матрицы вместо двух →F = ⅔ · 4D = 8D/3, чтобы сохранить число параметров. Вывод:2·D·4D = 8D² = 3·D·F. Округляют вверх до кратного 256: приD = 4096выходит11008. Одна проекция несёт значение, вторая через Swish решает, сколько его пропустить. Это мультипликативное взаимодействие, и при равных параметрах качество выше, чем у ReLU-FFN
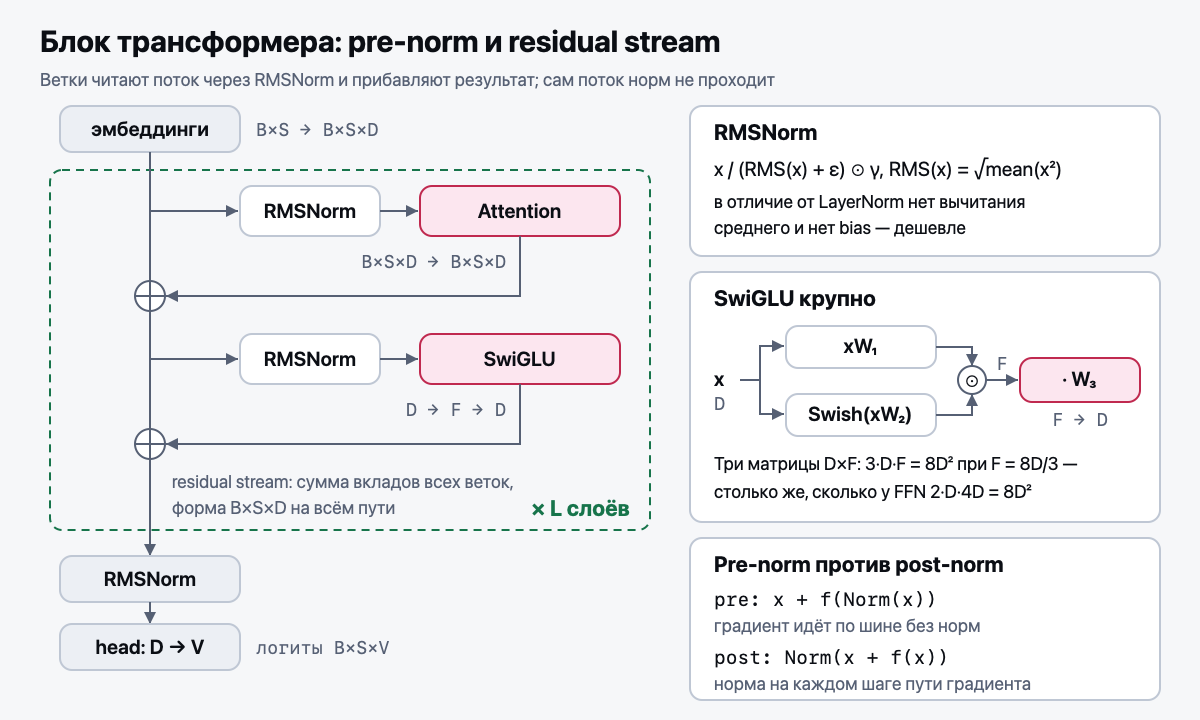
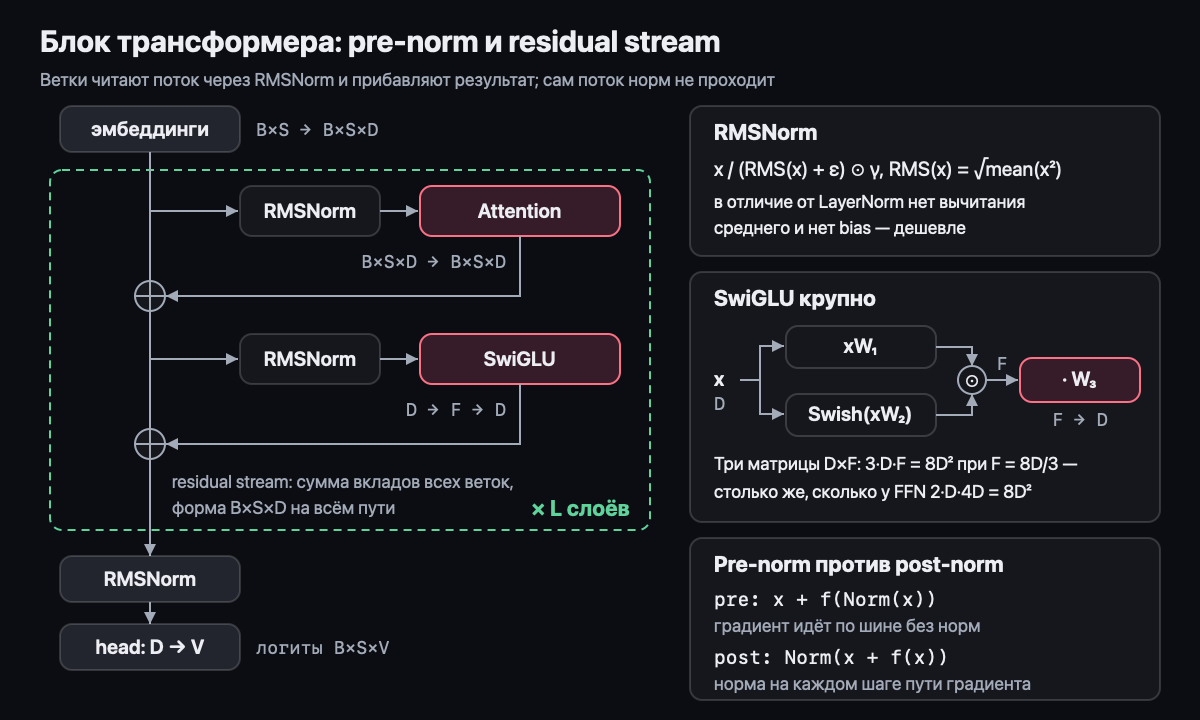
- Weight tying входных и выходных эмбеддингов (одна матрица на вход и на голову): экономит
V·D, у GPT-2 small это около трети всех параметров. У больших моделей доля мала, а роли матриц разные: одна читает токен, другая предсказывает следующий. Поэтому связывание там часто снимают
Типичные ошибки
- Вычитать среднее «по привычке»: получится LayerNorm без bias, ловит
test_rmsnorm_does_not_center. Нормировать не по той оси:test_rmsnorm_produces_unit_rms; забытьγ:test_rmsnorm_scales_with_gamma - Считать норму в bf16 (16 бит: порядок как у fp32, мантисса короткая; подробно в неделе 14): сумма квадратов теряет точность. Эталон переводит вход в fp32 и обратно
- Прибавлять к потоку нормированный
xвместо сырого: путь через единицу исчезает. Отдельного теста нет: ловится сверкой логитов в неделе 8 - Взять
F = 4Dпри трёх матрицах: параметров в 1.5 раза больше, ловитtest_swiglu_ffn_dim_is_8D_over_3(вtest_budget.py)
Код → nanolm/modules.py: RMSNorm и SwiGLU с нуля (w_gate, w_up, w_down), сверка
с эталонной реализацией. Конфигурация лежит в ModelConfig в config.py (H, G, ffn_dim, tie_embeddings),
сборка в Block в model.py. Задание exercises/modules.py, проверка: NANOLM_IMPL=exercises pytest tests/test_modules.py -k "rmsnorm or swiglu" -v.
Математика (трек D): D3: геометрия LayerNorm и RMSNorm через проектор; D4: Марков,
Чебышёв и концентрация нормы: почему на инициализации ‖x‖² ≈ D.
Интервью-вопрос недели: «Почему все перешли на pre-norm и что он ломает?» Структура на 3 минуты: post-norm в оригинале → норма на пути градиента, нужен warmup → pre-norm: путь через единицу → цена: рост нормы потока, финальная норма → варианты с нормой и на выходе ветки (Gemma 2, OLMo 2).
Источники: Xiong et al., On Layer Normalization in the Transformer Architecture (2020); Zhang & Sennrich, RMSNorm (2019); Shazeer, GLU Variants Improve Transformer (2020).
Глубже: 05-ГЛУБИНА, раздел «Что ещё добавить по мелочи», строка «Неделя 6».
Результаты недели
- Могу реализовать RMSNorm и SwiGLU с совпадением с эталоном.
- Могу вывести
F = 8D/3из условия равенства параметров SwiGLU и обычного FFN. - Могу за 2 минуты объяснить pre-norm против post-norm через путь градиента по residual stream.
- Могу назвать без подсказки всю нотацию
B, L, T, S, V, D, H, F, N, K, G.
Самопроверка
- Что RMSNorm убирает по сравнению с LayerNorm и зачем в нём обучаемая
γ? - Почему pre-norm обучается устойчивее post-norm?
- Что даёт weight tying и почему у больших моделей от него часто отказываются?