Неделя 5. Токенизация
Учиться в приложении: тьютор, задачи с кодом →
Ядро: BPE с нуля, byte-level, метрики и больные места токенизации · Глубина: WordPiece и Unigram, эмбеддинги в деталях, комбинаторика (трек D) · ≈ 11 ч ядро / 21 ч всё
Если токенизация твоя область, на интервью по ней будут копать глубоко.
Модель никогда не видит текст, только номера токенов. Всё, что токенизатор склеил или разрезал неудачно, модель потом выучивает обходным путём: отсюда проблемы с арифметикой, кодом и русским. Размер словаря прямо входит в число параметров (неделя 9) и в то, сколько текста влезает в контекст.
Шаг 1. Уровень разбиения: компромисс длины и словаря
На пальцах. Словарь это набор штампов. Если штампы есть только на целые слова, новое слово «трансформерный» напечатать нечем. Если только на буквы, напечатать можно всё, но каждое слово превращается в десяток оттисков. Subword-словарь заводит штампы на частые куски: «транс», «форм», «ный». Byte-level добавляет гарантию: в наборе всегда есть 256 штампов на отдельные байты, поэтому любой текст печатается, в худшем случае побайтно.
- Уровни: символы / байты / слова / subword. Компромисс длины последовательности и размера словаря
- Word-level: словарь в сотни тысяч, незнакомое слово превращается в
<unk>(токен «неизвестно»), словоформы не делят статистику. Байты: словарь крошечный, но последовательность в разы длиннее. Внимание платит за длину квадратично - Цена byte-level для русского: кириллица в UTF-8 занимает 2 байта на букву. «привет, мир» весит 20 байт, «hello, world» 12. Русский стартует с более длинной последовательности ещё до всяких слияний
Шаг 2. BPE: жадное сжатие
На пальцах. Корпус: «кот» ×4, «кода» ×3, «код» ×5. Считаем соседние пары букв с учётом частот: «к»+«о» встречается 4 + 3 + 5 = 12 раз, чаще всех. Она становится новым токеном «ко». Пересчитываем: теперь «ко»+«д» встречается 3 + 5 = 8 раз: это следующий токен «код». Два шага, и частое слово стало одним токеном, а редкое «кода» двумя: «код» + «а».
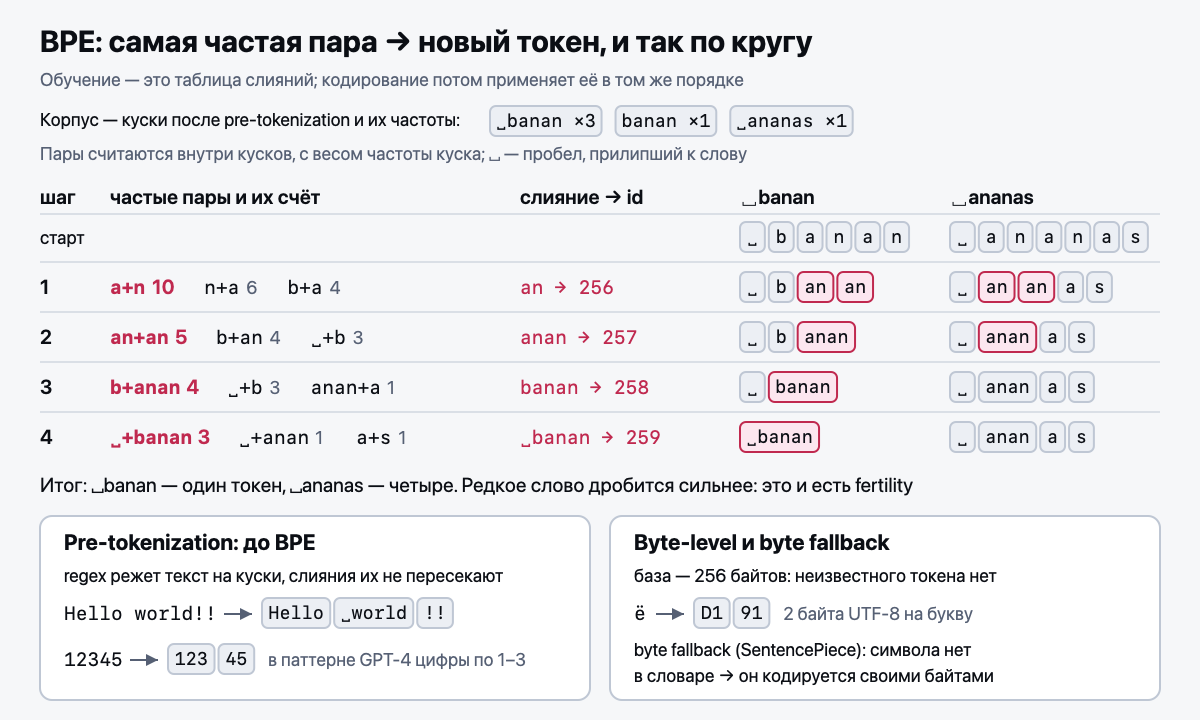
- BPE: обучение (слияние самой частой пары), кодирование, byte-level BPE, byte fallback
(незнакомый символ раскладывается на байты вместо
<unk>) - Обучение: посчитать пары соседей во всех кусках, слить самую частую в новый id, повторить
V − 256раз - Кодирование это не «самое длинное совпадение», а повтор слияний в порядке обучения. На каждом шаге сливается пара с наименьшим номером. Иначе получится сегментация, которой модель не видела
- Pre-tokenization regex (GPT-2/GPT-4 паттерны) и почему он важнее, чем кажется. Он режет текст на куски
до BPE. Без него слияния идут через границы слов, и словарь тратится на куски вроде
" the end of"
- WordPiece, Unigram / SentencePiece: чем отличается критерий слияния. WordPiece берёт пару
с наибольшим
count(ab) / (count(a)·count(b)), то есть прирост правдоподобия, а не частоту. Unigram идёт сверху вниз: удаляет токены, без которых правдоподобие корпуса падает меньше всего - Метрики: fertility (токенов на слово), compression rate (байт на токен). Модели с разными токенизаторами по лоссу на токен сравнивать нельзя, только в битах на байт
- Больные места: числа (почему арифметика ломается), код и отступы, мультиязычность (налог на не-английские языки), пробел перед словом, glitch-токены (
SolidGoldMagikarp): токен есть в словаре, но почти не встречался в данных модели, и его эмбеддинг остался необученным - Влияние словаря на матрицу эмбеддингов и на софтмакс-голову:
V·Dпараметров на каждую и2·D·VFLOPs (операций с плавающей точкой: каждое умножение и каждое сложение по одной; подробно в неделе 9) на токен в голове. Чем большеV, тем короче последовательности, но каждый токен реже встречается в обучении (D2)
Шаг 3. От id к вектору: эмбеддинги
На пальцах. Три слова на плоскости: «кошка» (1, 0.2), «собака» (0.9, 0.3), «самолёт» (0.1, 1).
Косинус угла между «кошкой» и «собакой» 0.96 / (1.020 · 0.949) ≈ 0.99, между «кошкой» и «самолётом»
0.3 / (1.020 · 1.005) ≈ 0.29. Длина вектора здесь не важна, важен угол: поэтому близость меряют косинусом.
- Эмбеддинг: строка матрицы
V × D, номер токена выбирает строку. В one-hot (вектор с единицей на месте номера) все слова одинаково далеки друг от друга; плотный вектор размераDпозволяет похожим словам оказаться рядом - Дистрибутивная гипотеза (смысл слова задают его соседи). word2vec учит векторы так, чтобы по слову угадывались
слова из его окна. Skip-gram с negative sampling (отрицательные примеры: случайные слова, которые соседями не были)
сводит это к логистической регрессии
σ(u_cᵀ v_w): настоящие пары сближаются, случайные расходятся. GloVe получает похожие векторы факторизацией матрицы совместной встречаемости - Косинусная близость
cos(a, b) = aᵀb / (‖a‖·‖b‖), от −1 до 1, не зависит от длины. Частые слова обычно получают длинные векторы, и скалярное произведение записало бы их в соседи ко всем подряд - Аналогии векторной арифметикой: «король − мужчина + женщина ≈ королева». Ищут ближайший по косинусу вектор
к
b − a + c, исключив самиa,b,c(иначе ответом часто выходитb). Работает на части отношений (столица, род, время глагола) и проваливается на многих других: это иллюстрация, а не закон - Статический эмбеддинг даёт слову один вектор на все значения («ключ» от замка и «ключ» как родник). Трансформер берёт такой же вектор на входе, а внимание делает его контекстным (недели 6–8). Те же косинусы работают в плотном поиске (неделя 21)
Типичные ошибки
- Декодировать каждый токен в строку отдельно: токен может резать многобайтовый символ. Сначала
склеить байты, потом
decode. Ловятtest_bytes_are_always_encodableиtest_roundtrip(эмодзи) - Кодировать жадным длинным совпадением вместо порядка слияний. Все тесты
test_tokenizer.pyостанутся зелёными: декодирование верно при любой сегментации. Ловит только сверка id с эталоннымnanolm.tokenizerна одном корпусе. Roundtrip необходим, но не достаточен - Пропускать спецтокены через regex и слияния:
<|endoftext|>развалится на куски, ловитtest_special_tokens_are_atomic. Отрезать ведущий пробел: ловитtest_leading_space_matters
Код → nanolm/tokenizer.py: BPE-тренер и кодер/декодер с нуля. BPETokenizer: train
(GPT2_SPLIT_PATTERN, _get_pair_counts, _merge), _encode_chunk, encode, decode, add_special_tokens,
fertility, compression_ratio. Задание: exercises/tokenizer.py, проверка: NANOLM_IMPL=exercises pytest tests/test_tokenizer.py -v.
Обучить на небольшом корпусе, сравнить fertility с tiktoken (test_fertility_shows_language_tax видит налог уже на игрушке).
Математика (трек D): D1: энтропия как нижняя граница средней длины кода (почему сжатие BPE упирается в энтропию текста); D2: сколько токенов словаря не встретится в корпусе.
Интервью-вопрос недели: «Почему LLM ошибается в арифметике и не может посчитать буквы в слове?» Структура на 3 минуты: модель видит id, а не символы → буквы внутри токена доступны только через выученный эмбеддинг → числа режутся неравномерно, разряды не выровнены → решения: цифры по одной (Llama 1–2), группы до 3 цифр (regex GPT-4), выравнивание справа налево, калькулятор → цена: длина.
Источники: Sennrich et al., Subword Units (2016); Radford et al., GPT-2 (2019), byte-level BPE; Kudo, Subword Regularization (2018), Unigram; Kudo & Richardson, SentencePiece (2018).
Результаты недели
- Могу реализовать BPE-тренер, кодер и декодер с нуля, с точным обратным преобразованием на произвольных байтах.
- Могу посчитать fertility и compression rate своего токенизатора и
tiktokenна русском и английском. - Могу за 3 минуты объяснить, как токенизация чисел мешает арифметике.
- Могу объяснить, почему у byte-level BPE не бывает неизвестных токенов.
- Могу объяснить, почему зелёный roundtrip-тест не доказывает правильность кодирования.
Самопроверка
- Чем отличается критерий слияния в BPE, WordPiece и Unigram?
- Зачем нужен pre-tokenization regex и что пойдёт не так без него?
- Как размер словаря влияет на число параметров и на длину последовательности, и откуда «налог» на неанглийские языки?
- Почему близость эмбеддингов меряют косинусом, а не скалярным произведением, и зачем в задаче аналогий исключать слова запроса?