Неделя 7. Внимание
Учиться в приложении: тьютор, задачи с кодом →
Ядро: деление на √H и маска, MHA/MQA/GQA, RoPE, компромиссы позиционных кодировок · Глубина: QK-norm, графовые сети и трансформер как GAT · ≈ 12 ч ядро / 23 ч всё
Внимание это единственное место, где токены обмениваются информацией; всё остальное в блоке работает с каждым токеном отдельно. Отсюда растут главные расходы инференса (KV-кэш, неделя 11), главное узкое место GPU (неделя 13) и все проблемы длинного контекста (неделя 20).
Шаг 1. Масштаб и маска
На пальцах. Сложи 64 случайных числа, каждое +1 или −1: сумма обычно порядка ±8, а не ±1.
Скалярное произведение q·k это такая же сумма из H слагаемых, и её разброс растёт как √H.
Softmax от чисел порядка ±8 выдаёт почти one-hot: один ключ забирает всё внимание, остальные ноль.
Через такой softmax градиент почти не проходит. Деление на √H возвращает числа к порядку ±1.
- Scaled dot-product:
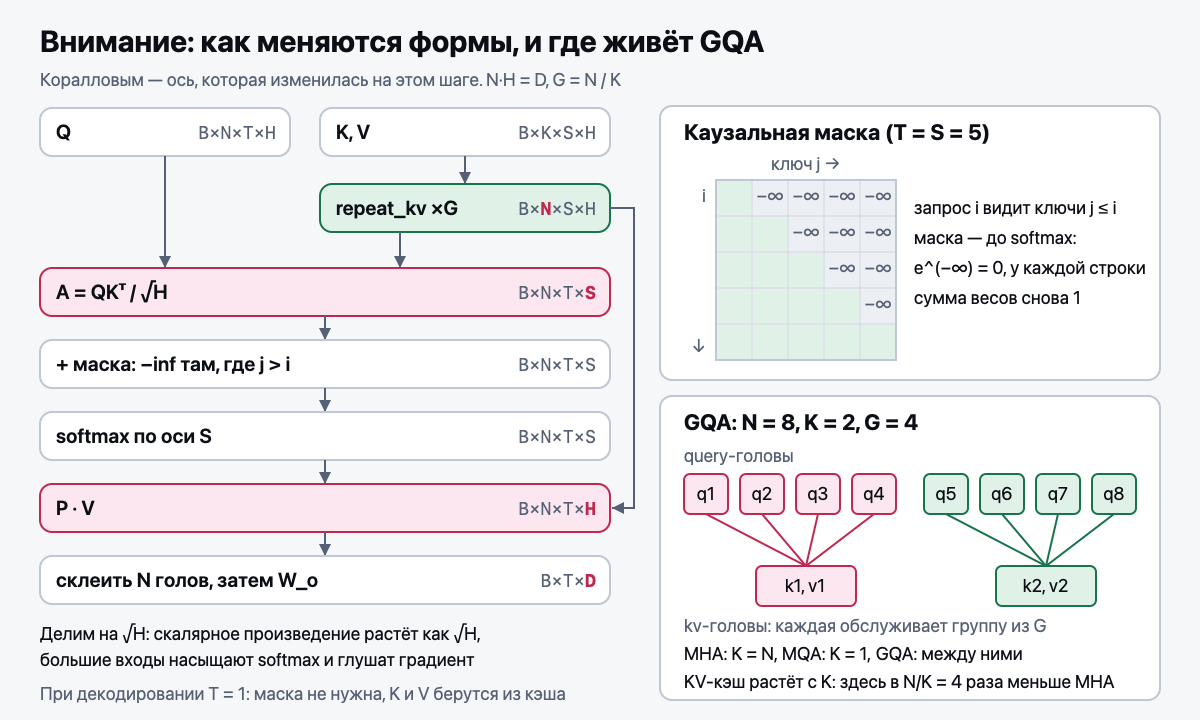
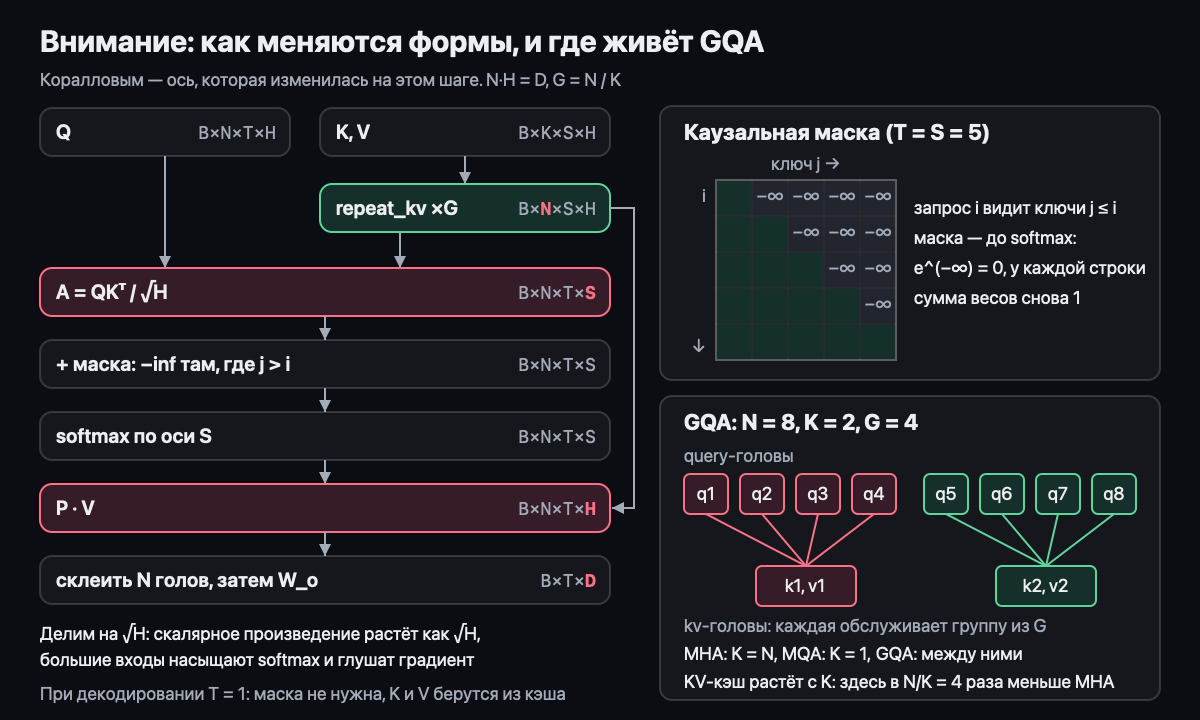
A = QKᵀ/√H. Почему делим: скалярные произведения растут как√H, большие входы в softmax → пиковое распределение → почти нулевые градиенты. Вывод (D5): при независимых координатах с единичной дисперсиейVar(q·k) = Σ Var(qᵢkᵢ) = H - Каузальная маска:
−infдо softmax. Тогдаe^{−inf} = 0, и строка нормируется только по прошлому. Маска после softmax обнулила бы веса, но сумма строки перестала бы быть единицей
Шаг 2. Сколько голов K/V
На пальцах. 32 читателя (query-головы) ищут по картотекам (key/value-головы). В MHA у каждого своя картотека, всего 32 штуки, и все их надо хранить в кэше. MQA: одна картотека на всех, кэш в 32 раза меньше, но все ищут по одним карточкам, и качество падает. GQA: 8 картотек, по одной на группу из 4 читателей, кэш в 4 раза меньше, разнообразие почти сохраняется.
- MHA → MQA → GQA:
K, Vрасширяются сKголов доNголов. Мотивация: размер KV-кэша. Кэш и матрицыW_k,W_vуменьшаются ровно вN/Kраз (у Llama-3-8B32/8 = 4). GQA-модель можно получить из MHA-чекпоинта, усреднив головы внутри группы и немного дообучив
Шаг 3. Позиция как поворот
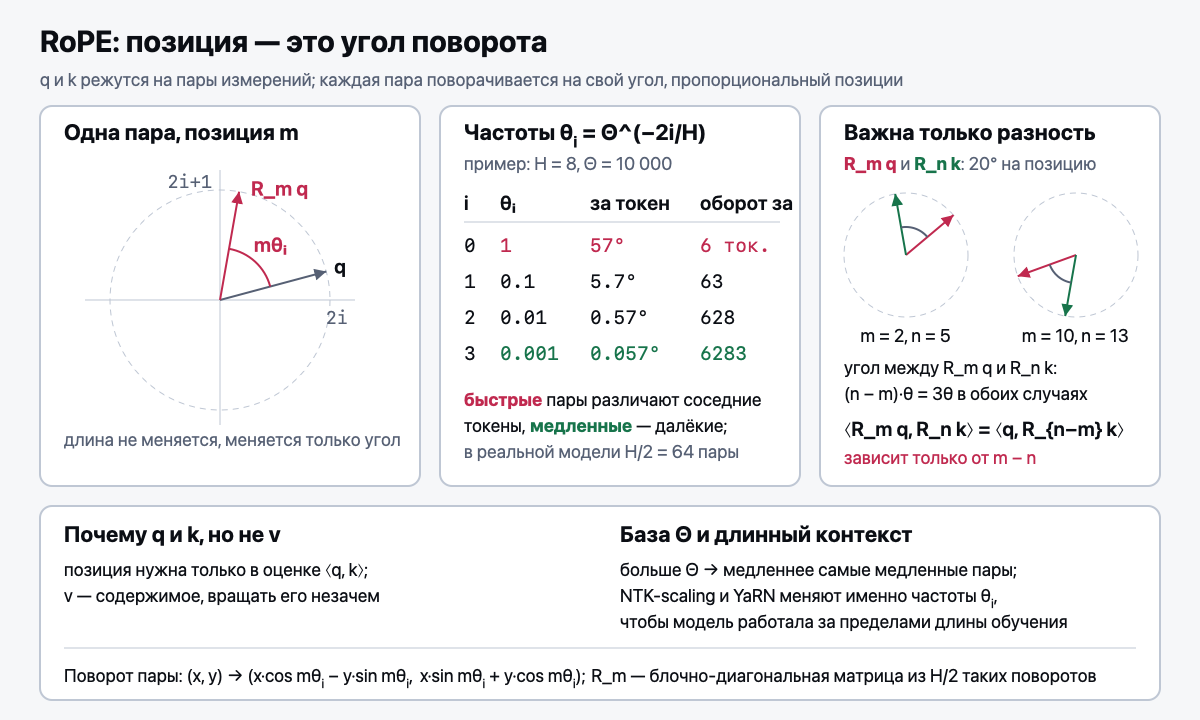
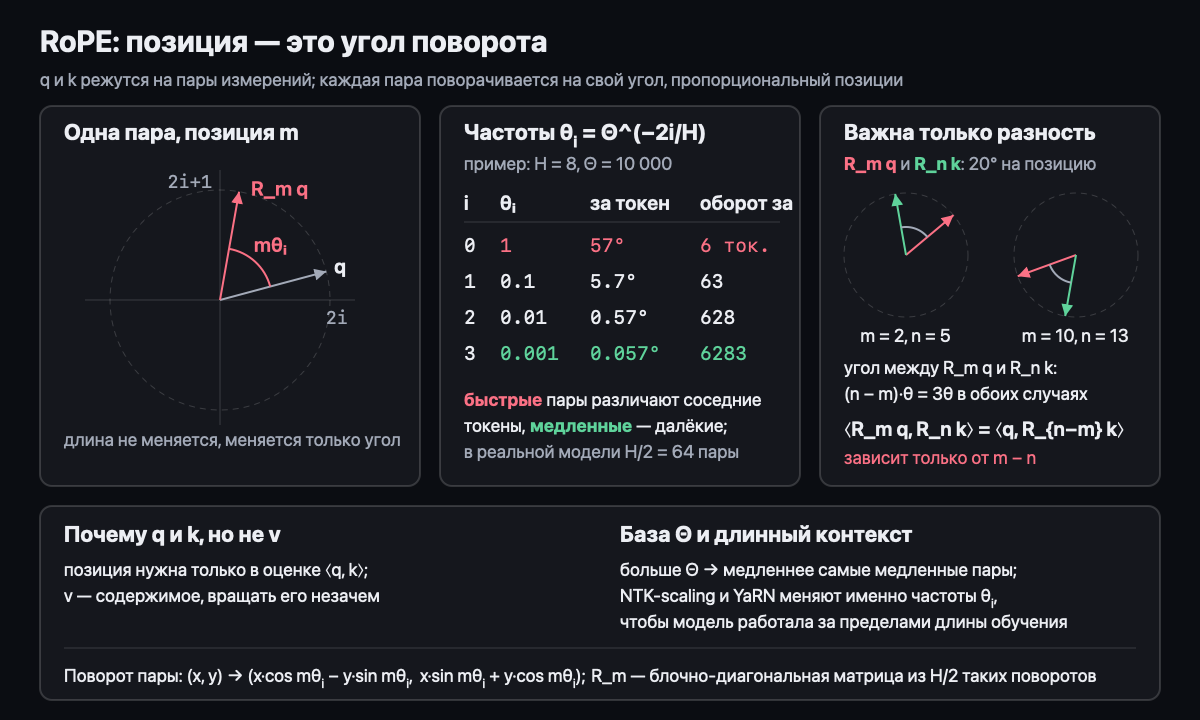
На пальцах. На каждой паре координат стоит стрелка. Позиция токена задаёт, сколько раз её повернуть: токен на позиции 3 повёрнут на 3 шага, на позиции 7 на 7 шагов. Скалярное произведение видит только угол между стрелками, то есть разность 7 − 3 = 4. Пара позиций 103 и 107 даст тот же угол. Пары вращаются с разной скоростью: быстрые, как секундная стрелка, различают соседей; медленные, как часовая, различают дальние расстояния.
- RoPE: поворот пар измерений на угол
mθᵢ, гдеθᵢ = Θ^(−2i/H)- Вывести, почему
⟨R_m q, R_n k⟩зависит только отm−n: это и есть относительность позиций. Ключевой шаг:(R_m q)ᵀ R_n k = qᵀ R_mᵀ R_n k = qᵀ R_{n−m} k, потому что поворот ортогонален (R_mᵀ = R_{−m}), а повороты одной плоскости складывают углы. В комплексной форме пара становится числомq̃ᵢ, поворот умножением наe^{imθᵢ}, а скор равенRe Σ q̃ᵢ · conj(k̃ᵢ) · e^{i(m−n)θᵢ} - Роль базы
Θ, экстраполяция контекста, NTK-scaling, YaRN. Самая медленная пара делает оборот примерно за2πΘпозиций; увеличитьΘзначит растянуть все периоды (подробно в неделе 20) - Сравнить с absolute / learned / ALiBi позиционным кодированием
- Вывести, почему
- Поворачиваются только
qиk, но неv: позиция решает, кто с кем взаимодействует, а не что передаётся - QK-norm: RMSNorm на q и k перед скалярным произведением, контроль масштабов. Без неё логиты внимания у больших моделей могут неограниченно расти, и обучение разваливается
- Sliding window, attention sinks. Окно ограничивает кэш размером окна. Sink (сток внимания): softmax обязан куда-то деть массу, и модели сливают её на первые токены, поэтому их нельзя выбрасывать из окна
Расширение (по желанию). Внимание как передача сообщений по графу
Для nanolm этот шаг не нужен, но он меняет взгляд на внимание: трансформер оказывается графовой сетью
(GNN, graph neural network) на полном графе. В этом разделе A обозначает матрицу смежности
(таблицу «кто с кем соединён»), а не оценки внимания из шага 1.
На пальцах. Четыре узла по кругу: 0–1–2–3–0. Матрица смежности A размера S × S (здесь S = 4)
хранит 1 там, где есть ребро: в строке узла 0 единицы стоят в столбцах 1 и 3. У каждого узла один признак,
X = [1, 2, 3, 4]. Шаг передачи сообщений (message passing): каждый узел собирает признаки соседей и свой
и усредняет их. Узел 0 получает (1 + 2 + 4)/3 = 7/3, узел 1 получает (2 + 1 + 3)/3 = 2.
За один слой узел узнаёт только о соседях, за k слоёв об узлах на расстоянии до k рёбер.
- GCN (graph convolutional network, графовая свёрточная сеть; Kipf, Welling, 2017):
X′ = à X W, где = A + I,d_iсумма строкиiматрицыÂ(степень узла вместе с самопетлёй),Ã[i, j] = Â[i, j] / √(d_i · d_j). В статьях это пишут какD^(−1/2) (A + I) D^(−1/2)с диагональной матрицей степеней; у насDзанята шириной модели, поэтому степени здесь векторd. Самопетля (ребро из узла в него самого) сохраняет собственный признак узла. Симметричная нормировка не даёт узлам с сотней соседей раздувать сумму. В круге все степени равны 3, иÃдаёт ровно среднее из примера; в цепочке 0–1–2 степени 2, 3, 2, и ребро 0–1 весит1/√6 ≈ 0.41.Wформы(D, D′)одна на все узлы, как одна проекция на все токены - Изотропная агрегация (вес соседа задан только степенями, а не содержанием): GCN не умеет решить, что один сосед важнее другого. Два соседа с одинаковой степенью всегда получают одинаковый вес
- GAT (graph attention network, графовая сеть с вниманием; Veličković et al., 2018): веса соседей считает
внимание. Оценка есть только у пар «узел и его сосед» и у узла с самим собой, softmax берётся по соседям,
остальным парам ставится
−inf. Это анизотропная агрегация: два соседа с одной и той же степенью могут получить веса 0.9 и 0.1. В статье GAT оценку пары считает маленькая сеть над склеенными признаками, а неq·k/√H, но суть та же: вес зависит от содержания узлов - Трансформер это GAT на полном графе. Если каждый токен соединён с каждым, маска пустая, и внимание
по соседям превращается в обычное
softmax(QKᵀ/√H) V. Каузальная маска задаёт граф «токен видит себя и предыдущих» (нижний треугольник), sliding window задаёт граф-полосу шириной в окно. Граф хранит только связи, порядка в нём нет: поэтому трансформеру нужен RoPE, а графовым сетям иногда добавляют позиционные признаки узлов - Цена и выгода. Полный граф даёт
S²пар, разреженный граф сEрёбрами толькоE. Зато в трансформере любые два токена связаны за один слой. В GCN сигнал проходит одно ребро за слой, а при многих слоях признаки узлов усредняются почти до одинаковых (oversmoothing, пересглаживание)
Тренажёр: задачи gcn_layer и graph_attention; во второй проверяется, что на полном графе выходит обычное
внимание, а на графе «вижу предыдущих» каузальное. Слайды по теме: лекция Xavier Bresson о графовых
свёрточных сетях (ссылка в «Ресурсах»).
Типичные ошибки
- Забыть
/√H: ловятtest_attention_scale_is_one_over_sqrt_head_dim,test_naive_attention_matches_pytorch repeat_kvчерез чередование голов (x.repeat) вместо повтора подряд: группы перепутаются, ловитtest_repeat_kv_groups_correctly- Поворачивать не те пары или с ошибкой в знаке:
test_rope_preserves_norm,test_rope_is_identity_at_position_zero, главный из нихtest_rope_makes_attention_relative view(B, N, T, H)сразу вместоview(B, T, N, H).transpose(1, 2): смешивает токены между головами; утечку будущего ловитtest_attention_is_causal
Код → nanolm/modules.py: attention с GQA и RoPE с нуля. RoPE (таблицы cos/sin, forward(x, offset)),
repeat_kv, Attention (w_q, w_k, w_v, w_o, опция qk_norm), naive_attention.
Задание: exercises/modules.py, проверка: NANOLM_IMPL=exercises pytest tests/test_modules.py -v.
Тест: результат совпадает с F.scaled_dot_product_attention до 1e-5.
Математика (трек D): D5: дисперсия скалярного произведения и производная softmax с масштабом и без; D6: относительность RoPE, комплексная форма и самая длинная «длина волны».
Интервью-вопрос недели: «Назови все способы кодировать позицию и их компромиссы». Нужно рассказать 4 минуты без пауз. Структура: где вносится позиция (вход или скоры внимания) → sinusoidal и learned (абсолютные; learned ограничена длиной обучения) → относительные смещения (T5, ALiBi: штраф, линейный по расстоянию) → RoPE (поворот, относительность через ортогональность, совместим с KV-кэшем) → NoPE (каузальная маска сама даёт сигнал о позиции) → экстраполяция у каждого.
Источники: Vaswani et al. (2017); Shazeer, MQA (2019); Ainslie et al., GQA (2023); Su et al., RoFormer (2021); Press et al., ALiBi (2021); Xiao et al., Attention Sinks (2023); Kipf, Welling, GCN (2017); Veličković et al., GAT (2018).
Глубже: 05-ГЛУБИНА, разделы «Неделя 7. RoPE: частотный дизайн» и «Что ещё добавить по мелочи».
Результаты недели
- Могу вывести, что
⟨R_m q, R_n k⟩зависит только отm − n, в комплексной форме за 5 минут. - Могу реализовать attention с GQA и RoPE, совпадающий с
F.scaled_dot_product_attentionдо 1e-5. - Могу посчитать, во сколько раз GQA уменьшает KV-кэш при заданных
NиK. - Могу 4 минуты без пауз рассказывать о способах кодировать позицию и их компромиссах.
Самопроверка
- Выведи из дисперсии скалярного произведения, почему оценки делят на
√H. - Почему RoPE поворачивает
qиk, но неv? - Как GQA сводится к MHA и к MQA при крайних значениях
K? - (Расширение) Чем слой GCN отличается от слоя GAT? Почему трансформер можно назвать GAT на полном графе и какой граф задаёт каузальная маска?
- (Расширение) Зачем GCN добавляет самопетли и делит вес ребра на
√(d_i · d_j)? Посчитай веса в строке узла 1 для цепочки 0–1–2.