Неделя 4. Теория информации и численная стабильность
Учиться в приложении: тьютор, задачи с кодом →
Ядро: энтропия, CE = KL + H, перплексия, logsumexp, online softmax · Глубина: n-граммы и сглаживание, Gumbel-Softmax, распределение Больцмана · ≈ 11 ч ядро / 22 ч всё
Лосс языковой модели это кросс-энтропия, и без теории информации не понять ни что он значит,
ни почему на старте он равен ln V (неделя 8). Вторая половина недели про численную стабильность: exp
переполняется в fp32 уже при x ≈ 88.7, и наивный softmax даёт NaN. Online softmax отсюда же, и это прямая
основа FlashAttention (неделя 13), а KL вернётся в RLHF и DPO (неделя 17).
Теория
На пальцах. Три исхода. Настоящее распределение p = (½, ½, 0), модель думает q = (¼, ¼, ½).
Энтропия H(p) равна 1 биту: лучший код для p тратит на исход 1 бит.
Код, построенный под q, тратит на первые два исхода по log₂ 4 = 2 бита.
Поэтому кросс-энтропия CE(p, q) = ½·2 + ½·2 = 2 бита, а переплата KL(p‖q) = 2 − 1 = 1 бит.
Обратная KL(q‖p) бесконечна: q ставит ½ на третий исход, которому p даёт ноль. KL несимметрична.
В лоссе логарифм натуральный: чтобы получить те же величины в натах, умножь на ln 2 ≈ 0.693.
- Энтропия (средняя неожиданность исхода,
−Σ p log p), кросс-энтропия, KL (дивергенция Кульбака–Лейблера: средняя переплата за то, что кодировали поq, когда правдаp). СоотношениеCE(p,q) = KL(p‖q) + H(p)нужно вывести - CE-loss при 1-hot цели = negative log likelihood следующего токена
- Вероятность всей последовательности. По цепному правилу (Модуль 0, F5)
log p(x₁…x_T) = Σ_t log p(x_t | x_<t), гдеx_<tвсе токены до позицииt. CE, усреднённая по позициям, равна ровно−(1/T)от этой суммы: обучаясь предсказывать следующий токен, модель максимизирует правдоподобие всего текста
На пальцах. Модель на каждом шаге честно колеблется между четырьмя равновероятными токенами: правильному
достаётся ¼. Средний лосс ln 4 ≈ 1.386, перплексия e^{1.386} = 4. Перплексия переводит лосс
в «число вариантов, между которыми модель в среднем выбирает». Лосс 3.4 даёт e^{3.4} ≈ 30 вариантов,
а равномерная модель на словаре V даёт ровно V.
- Перплексия
PPL = exp(−(1/T) Σ_t log p(x_t | x_<t)): экспонента от среднего CE на токен. Сравнима только при одном токенизаторе и одном тестовом тексте: другой словарь меняет иT, и сами вероятности (поэтому разные модели сравнивают в битах на байт, неделя 5)
На пальцах. Корпус a b a b a c. Биграммная модель (следующий токен зависит только от предыдущего) считает пары:
после a дважды шёл b и один раз c, отсюда p(b|a) = 2/3, p(c|a) = 1/3, p(a|a) = 0. Это MLE (Модуль 0, F5):
частота пары, делённая на частоту первого токена. В тесте встретилась пара a a: вероятность 0, лосс бесконечен.
Add-one (прибавить 1 к счёту каждой возможной пары, словарь из трёх токенов): p(a|a) = (0 + 1)/(3 + 3) = 1/6,
p(b|a) = 3/6, p(c|a) = 2/6. Ноль исчез, а частые пары отдали часть массы.
- N-граммная модель как бейзлайн:
p(x_t | x_{t−n+1} … x_{t−1})по счётчикам, обучение сводится к подсчёту. Две беды: невиданная n-грамма получает ноль, а возможных n-граммV^n, и почти все встречаются в корпусе ноль раз - Сглаживание: add-α
(count + α) / (count(prev) + α·V)(приα = 1это add-one, оно же сглаживание Лапласа); backoff и интерполяция (опереться на более короткий контекст:λ·p(c|ab) + (1 − λ)·p(c|b)); Kneser–Ney (лучший классический вариант: короткий контекст учитывает, после скольких разных слов встречалось слово). Нейросетевая LM снимает обе беды: softmax не даёт нулей, а похожие контексты получают похожие векторы - Перплексия биграммной модели на твоём токенизаторе это нижняя планка для nanolm: если обученный
трансформер её не обходит, ищи ошибку в коде (задача
bigram_perplexityв тренажёре) - Реализация лосса: сдвиг логитов/меток,
ignore_index(метка, которую лосс пропускает, например паддинг), маска потерь
На пальцах. exp(1000) не помещается ни в fp32, ни даже в fp64 (там предел около e^709), получается inf.
Softmax от [1000, 1001] в лоб даёт inf / inf = NaN. Вычтем максимум: [1000, 1001] − 1001 = [−1, 0].
Теперь e^{−1} ≈ 0.368, e^0 = 1, и ответ (0.269, 0.731). Ответ тот же самый:
числитель и знаменатель умножили на одно число e^{−1001}, и оно сократилось.
- Численная стабильность, где именно ломается:
exp(x)при больших x → overflow (переполнение: результат больше максимума типа и становитсяinf; в fp32 уже приx ≈ 88.7, в fp16 приx ≈ 11)log(x)при x→0 → underflow (исчезновение порядка: слишком маленькое число становится 0, аlog 0 = −inf); при x→1 → потеря точности
- Стабильный softmax: вычесть
x_max(softmax инвариантен к сдвигу: это нужно вывести)
На пальцах. Логиты (0, 200). Даже стабильный softmax даёт первому классу вероятность e^{−200} ≈ 10⁻⁸⁷.
В fp32 такого числа нет (наименьшее около 10⁻⁴⁵): получается 0, и log 0 = −inf.
А ответ существует и прост: log_softmax = x − logsumexp(x), для первого класса 0 − 200 = −200.
Логарифм надо считать сразу, не проходя через саму вероятность.
log_softmax = x − logsumexp(x)(никогда не материализовать крошечные вероятности)logsumexp(x) = x_max + log Σ exp(x − x_max)- Softmax как распределение Больцмана. В физике состояние с энергией
Eвстречается с вероятностьюe^{−E}/Z, гдеZ = Σ e^{−E_j}(статсумма: нормирующая сумма по всем состояниям). Softmax устроен так же: логит это минус энергия,Z = Σ e^{x_j}, аlogsumexp(x) = log Z. Логиты(3, 1, 0):Z ≈ 23.80,log Z ≈ 3.170,p ≈ (0.844, 0.114, 0.042). Сдвиг на −3 даёт(0, −2, −3):Z ≈ 1.185,log Z ≈ 0.170, то есть ровно на 3 меньше, аpте же. Температура сэмплирования (неделя 12) это физическая температура из той же формулы: логиты делят на неё
На пальцах. Поток из двух чисел x = (1, 3) со значениями v = (10, 20); нужно Σ softmax(x)ᵢ · vᵢ.
После первого: максимум m = 1, знаменатель d = e^{1−1} = 1, числитель o = 10.
Приходит 3, новый максимум. Старые d и o посчитаны относительно 1;
пересчитываем их к 3 умножением на e^{1−3} ≈ 0.135: d = 0.135 + 1 = 1.135, o = 1.35 + 20 = 21.35.
Ответ 21.35 / 1.135 ≈ 18.81. В лоб: веса softmax(1, 3) = (0.119, 0.881), и 10·0.119 + 20·0.881 ≈ 18.81.
Совпало, хотя весь поток сразу мы ни разу не держали.
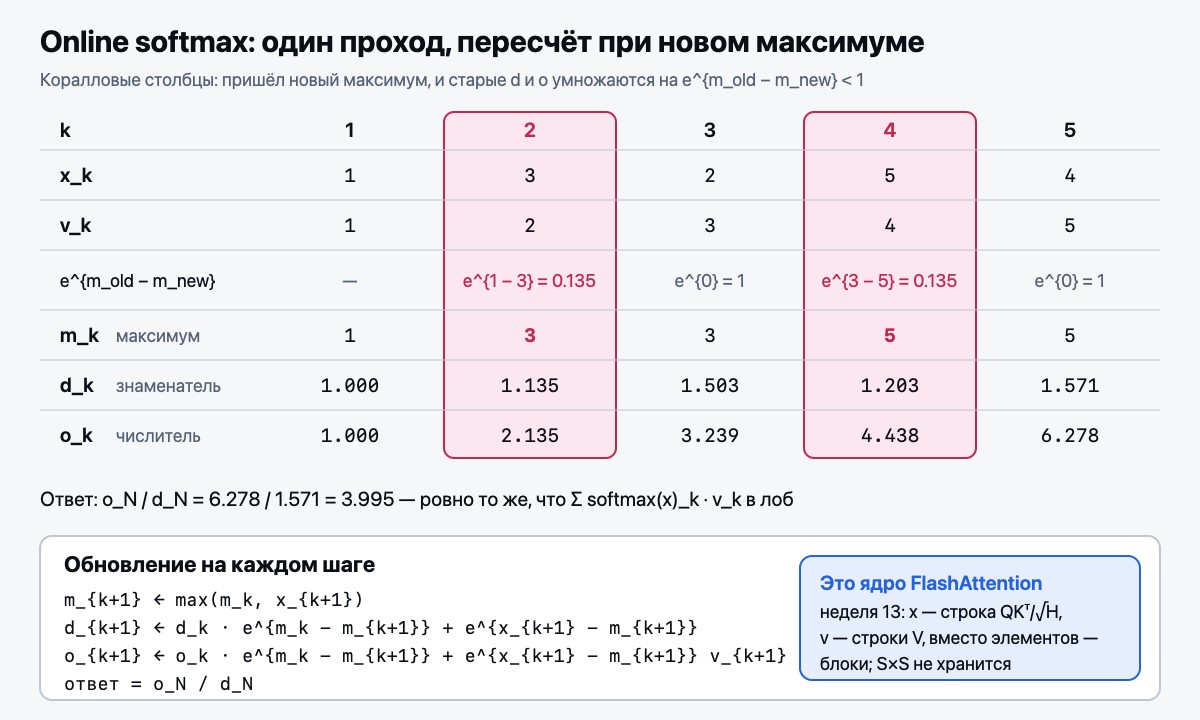
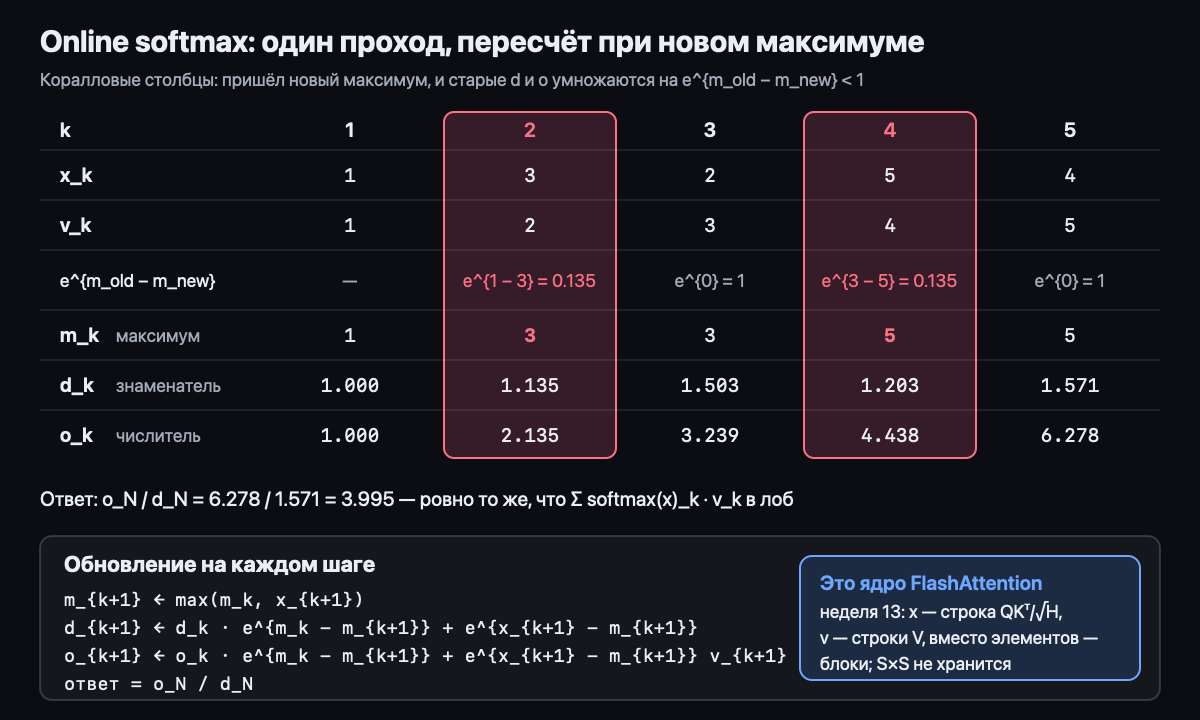
Online softmax trick (softmax за один проход по потоку, без хранения всех чисел) это фундамент FlashAttention, разобрать досконально:
m_{k+1} ← max(m_k, x_{k+1})
d_{k+1} ← d_k · e^{m_k − m_{k+1}} + e^{x_{k+1} − m_{k+1}}
o_{k+1} ← o_k · e^{m_k − m_{k+1}} + e^{x_{k+1} − m_{k+1}} v_{k+1}
ответ = o_N / d_N
Вывести корректность обновления
dв одну строку алгебры.
- Общая схема стабилизации
e^x: подобрать сдвигm(почти всегдаx_max), вынестиe^{m}за скобки и проверить, сокращается ли он. В softmax сокращается полностью, вlogsumexpостаётся отдельным слагаемымx_max. Оба случая это одно и то же преобразование - Градиенты через сэмплирование: Gumbel-Max (argmax от логитов плюс шум Гумбеля даёт точный сэмпл из softmax), Gumbel-Softmax (даёт стохастичность, а не дифференцируемость: softmax уже дифференцируем), straight-through estimator (в forward дискретный выбор, в backward градиент гладкой замены)
Код → nanolm/stability.py: logsumexp, стабильный softmax, log_softmax, online-softmax
для потокового взвешенного среднего. Тесты на переполнение (x = [1000, 1001]). Задание: exercises/stability.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_stability.py -v.
Математика (трек D): MLE, bias-variance.
Интервью-вопрос недели: «Как посчитать softmax без NaN и что делать, если вектор не помещается
в память целиком?» Структура на 3 минуты: (1) первым назови, где ломается: exp переполняется в fp32 при
x ≈ 88.7, в fp16 при x ≈ 11; [1000, 1001] в лоб даёт inf / inf = NaN; (2) лекарство: вычесть максимум,
e^{−m} сокращается, ответ (0.269, 0.731); (3) вторая ловушка, underflow: при логитах (0, 200)
вероятность ≈ 10⁻⁸⁷ становится нулём, log 0 = −inf; поэтому лосс считают через log_softmax = x − logsumexp(x),
вероятность не материализуют; (4) поток: online softmax хранит m, d, o и при новом максимуме
домножает старые на e^{m_old − m_new}; (5) вывод: это ядро FlashAttention (неделя 13); жди просьбы
доказать обновление d у доски: это одна строка: d_k·e^{m_k − m_{k+1}} = Σ_{i≤k} e^{x_i − m_{k+1}}.
Глубже: 05-ГЛУБИНА, раздел «Недели 1–4, трек D. Математика: большой недобор».
Результаты недели
- Могу вывести
CE(p,q) = KL(p‖q) + H(p)и объяснить, почему минимизация CE поqэто то же, что минимизация KL. - Могу вывести корректность обновления знаменателя online softmax в одну строку алгебры.
- Могу реализовать
logsumexp,softmax,log_softmax, проходящие тест наx = [1000, 1001]. - Могу за 2 минуты объяснить, почему
log(softmax(x))нельзя считать в лоб.
Самопроверка
- При каком
xпереполняетсяexpв fp32 и почему вычитание максимума ничего не меняет в ответе? - Что хранит online softmax и как пересчитываются накопленные величины при новом максимуме?
- Зачем Gumbel-Softmax, если softmax и так дифференцируем?
- Модель дала правильным токенам вероятности
½,¼,⅛. Чему равна перплексия и как объяснить её словами? - Зачем биграммной модели сглаживание, почему оно не нужно трансформеру и чем плох add-one на большом словаре?
✅ Контрольная точка 1
Без подсказок за 90 минут:
- Вывести
∂L/∂zдля softmax+CE - Написать AdamW с нуля
- Объяснить, почему
logsumexpстабилен, и вывести online-softmax - Посчитать память обучения модели на 1.5B параметров в bf16 (16-битный формат с порядком как у fp32 и короткой мантиссой; подробно в неделе 14) с AdamW