Неделя 3. Оптимизаторы и режим обучения
Учиться в приложении: тьютор, задачи с кодом →
Ядро: SGD, momentum, Adam и bias correction, AdamW с нуля, warmup и clipping · Глубина: группы параметров, неравенства и предельные теоремы (трек D) · ≈ 10 ч ядро / 20 ч всё
Градиент говорит, куда идти, а оптимизатор решает, насколько. AdamW стоит почти во всех LLM, и его состояние вместе с fp32-копией весов занимает 12 из 16 байт на параметр (неделя 9), ровно то, что первым шардирует ZeRO (неделя 14). Без warmup и клиппинга не прочитать скачки лосса в неделе 10.
Теория
- SGD:
θ ← θ − ηg
На пальцах. В датасете четыре примера, их градиенты 1, 3, 5, 7, полный градиент равен среднему, 4.
Батч из одного случайного примера даёт 1, 3, 5 или 7, а в среднем ровно 4: оценка шумная, но не смещена
(её среднее совпадает с истиной). Батч из двух тоже даёт в среднем 4, но разброс меньше.
Дисперсия падает как 1/B, а стандартное отклонение как 1/√B: вчетверо больший батч снижает шум только вдвое.
- Стохастический градиент: градиент по случайному мини-батчу это несмещённая оценка полного,
E[g_B] = ∇J, с дисперсиейσ²/B(при выборке без возвращения чуть меньше). Шум не только мешает: он выбивает из узких минимумов и работает как неявная регуляризация
На пальцах. Градиент всё время равен 1, η = 0.1, μ = 0.9. SGD шагает на 0.1.
Momentum копит скорость v ← μv + g: 1, 1.9, 2.71, … и в пределе 1/(1 − μ) = 10.
Шаг дорастает до η·10 = 1: по ровному склону вдесятеро быстрее. Если же градиент скачет +1, −1, +1, …,
скорость колеблется около ±0.53 вместо ±1: поперёк оврага (вдоль оси, где знак градиента всё время меняется) раскачка гасится.
- Momentum (метод тяжёлого шара):
v ← μv + g,θ ← θ − ηv. Постоянная часть градиента накапливается (эффективный шаг доη/(1 − μ)), меняющая знак взаимно гасится. В Adam та же идея живёт вm, но как взвешенное среднее с множителем(1 − β₁), поэтому шаг не растёт в1/(1 − β₁)раз. Nesterov считает градиент в точке, куда шар и так докатится:g(θ − ημv)
На пальцах. Одна координата, градиент на каждом шаге g = 2, β₁ = 0.9, β₂ = 0.999, ε пренебрежимо мал.
Шаг 1: m = 0.1 · 2 = 0.2, v = 0.001 · 4 = 0.004. Оба стартовали с нуля и пока сильно занижены:
m вдесятеро (0.1·g, а не g), v в тысячу раз.
Поправка делит их на 1 − β₁¹ = 0.1 и 1 − β₂¹ = 0.001 и возвращает m̂ = 2, v̂ = 4. Шаг η · m̂/√v̂ = η · 2/2 = η.
Шаг 2: m = 0.38, v ≈ 0.008; после деления на 0.19 и ≈0.002 получаем снова 2 и 4, шаг снова η.
Шаг 3: m = 0.542, v ≈ 0.012, делители 0.271 и ≈0.003, шаг опять η.
Без поправки шаги были бы 3.2η, 4.2η, 5.0η: v занижен сильнее, чем m, и шаг раздувается.
И главное: при g = 200 шаг был бы тем же η. Adam делит градиент на его собственный масштаб.
- Adam: первый момент
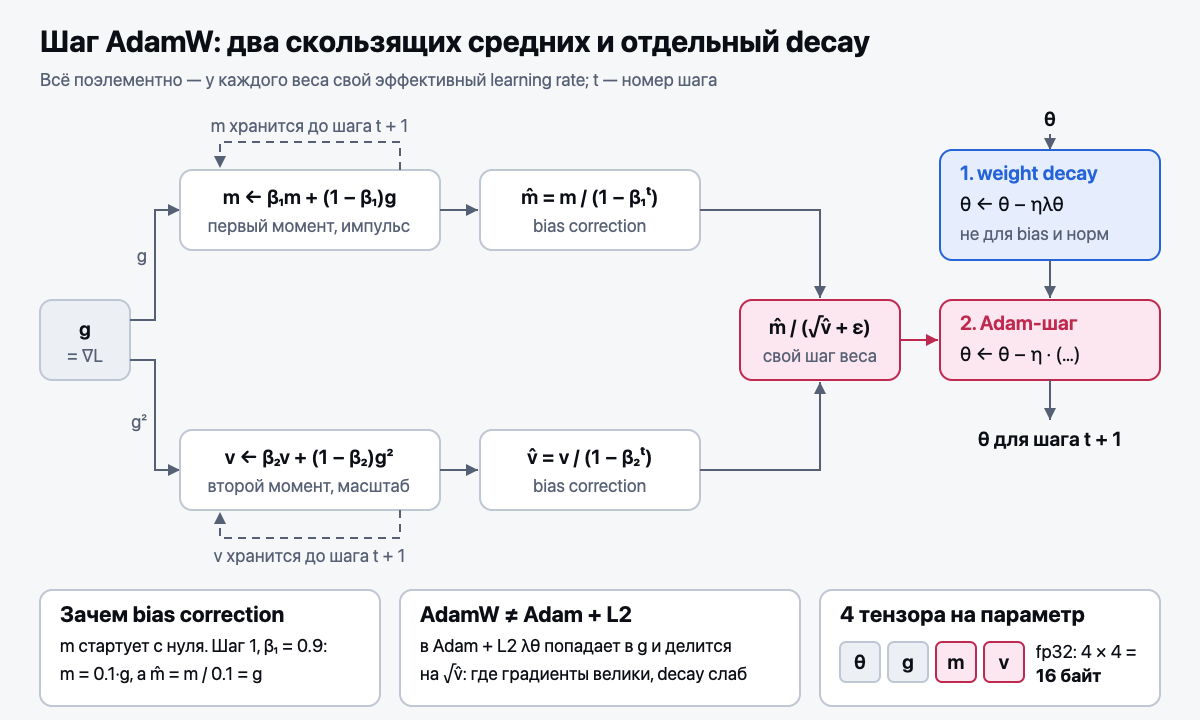
m(импульс, скользящее среднее градиентов), второй моментv(скользящее среднее квадратов градиента, нормализация масштаба). Фактически у каждого веса свой эффективный learning rate - Bias correction:
m̂ = m/(1−β₁ᵗ), нужна потому чтоm, vинициализированы нулями - Память ≈ 4× размера параметров (θ, g, m, v). Это основа всех расчётов памяти обучения
На пальцах. Weight decay (притягивание весов к нулю на каждом шаге) хочет уменьшить два веса
на одну и ту же величину, λθ = 0.01. Adam с L2 кладёт λθ в градиент, а потом делит всё на √v̂.
У веса с градиентами порядка 10 штраф превращается в 0.01 / 10 = 0.001,
а у веса с градиентами порядка 0.1 превращается в 0.01 / 0.1 = 0.1. Разница в сто раз:
веса с большими градиентами почти не регуляризуются. AdamW вычитает ηλθ отдельно,
мимо деления на √v̂, и одинаково для обоих.
- AdamW: weight decay отдельным членом
−ηλθ, применять до шага Adam - Parameter groups (группы параметров со своими настройками): не применять weight decay к bias и к параметрам норм
- Эвристика: зависит только от шага
t→ это LR schedule (расписание learning rate); требует истории по параметру → это оптимизатор - Warmup (разгон LR с нуля за первые шаги; снижает эффект первенства ранних примеров), cosine decay (спад LR по половине косинуса к концу обучения)
На пальцах. Градиент двух весов (3, 4), его норма 5, порог клиппинга 1.
Клиппинг по глобальной норме делит весь вектор на 5: (0.6, 0.8). Длина стала 1, направление прежнее.
Поэлементный клиппинг обрезал бы каждую координату до 1: (1, 1).
Это уже другое направление: шаг пойдёт не туда, куда указывал градиент.
- Gradient clipping по глобальной норме: если норма всех градиентов вместе больше порога,
все они умножаются на одно число
порог / норма
Одна фраза, которая связывает Adam с неделей F4: Adam это диагональное
предобуславливание (своя поправка масштаба для каждой координаты). Деление на √v̂ выравнивает
масштаб градиентов по координатам, то есть уменьшает эффективное число обусловленности задачи
(отношение самой крутой кривизны к самой пологой). Momentum в той же
картине выглядит как «тяжёлый шар», который не реагирует на каждую кочку ландшафта.
Доп. чтение: Li, Mathematical Pathways to ML (2026), 12.5 и 11.5.
Код → nanolm/optim.py: написать AdamW(torch.optim.Optimizer) с нуля: __init__ с defaults,
step() с состоянием на параметр. Сверить с torch.optim.AdamW до 1e-6. Задание: exercises/optim.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_optim.py -v.
Математика (трек D): неравенства Маркова, Чебышёва, Йенсена. ЗБЧ и ЦПТ.
Интервью-вопрос недели: «Чем AdamW отличается от Adam с L2-регуляризацией и почему это важно?»
Структура на 3 минуты: (1) первым скажи, что делает Adam: m, v, шаг m̂/√v̂, у каждого веса свой
эффективный learning rate; (2) L2 кладёт λθ в градиент, и он тоже делится на √v̂: при градиентах
порядка 10 и 0.1 штраф различается в 100 раз, и веса с большими градиентами почти не регуляризуются;
(3) вывод: AdamW вычитает ηλθ отдельно, мимо m и v, одинаково для всех весов; (4) практика:
группы параметров, без weight decay на bias и нормах; цифра: 4 тензора на параметр (θ, g, m, v),
16 байт в mixed precision; (5) жди «а зачем bias correction». Без неё v занижен сильнее m,
и первые шаги раздуваются до 3.2η, 4.2η, 5.0η вместо η.
Глубже: 05-ГЛУБИНА, раздел «Недели 1–4, трек D. Математика: большой недобор».
Результаты недели
- Могу реализовать AdamW как
torch.optim.Optimizerс совпадением с эталоном до 1e-6. - Могу посчитать, чему равно
mна первом шаге без bias correction, и объяснить, зачем поправка. - Могу посчитать память на состояние оптимизатора для модели из
Nпараметров в fp32. - Могу разбить параметры на группы с weight decay и без и обосновать разбиение.
Самопроверка
- Чем AdamW отличается от Adam с L2-регуляризацией и почему разница важна именно для адаптивных методов?
- Зачем warmup, если у Adam и так своя нормировка шага?
- Что сохраняет клиппинг по глобальной норме, чего не сохраняет поэлементный?
- Почему градиент по мини-батчу это несмещённая оценка полного и во сколько раз надо увеличить батч, чтобы вдвое снизить шум?
- Во сколько раз momentum с
μ = 0.9ускоряет спуск по ровному склону и что он делает с колебаниями поперёк оврага?