Неделя 2. Backpropagation
Учиться в приложении: тьютор, задачи с кодом →
Ядро: вычислительный граф, градиент softmax+CE, свой autograd, activation checkpointing · Глубина: прямой режим автодифференцирования, непрерывные распределения (трек D) · ≈ 11 ч ядро / 21 ч всё
Backprop это единственный способ, которым учится всё в этом курсе, от MLP до RLHF. Его ошибки
не падают с исключением: градиент, перезаписанный вместо сложенного, просто учит модель хуже.
Здесь же появляются p − one_hot(t), который вернётся в policy gradient (неделя 16), и checkpointing,
без которого активации больших моделей не помещаются в память (неделя 9).
Теория
- Вычислительный граф (вычисление, записанное узлами-операциями, по рёбрам которых текут числа). Разбиение на «гейты» (узлы) это вопрос удобства: гейт ставят там, где локальный градиент прост
downstream = upstream × local. Здесь upstream: градиент лосса по выходу узла; local: производная выхода узла по его входу; downstream: градиент лосса по этому входу
На пальцах. Граф: q = x + y, затем f = q · z. Входы x = 1, y = 2, z = 4; forward даёт q = 3, f = 12.
Backward идёт с конца, upstream на выходе равен 1. Узел ×: ∂f/∂z = q = 3, ∂f/∂q = z = 4: множители поменялись местами.
Узел +: local по каждому входу равен 1, поэтому ∂f/∂x = ∂f/∂y = 4 · 1 = 4.
Проверка: x = 1.01 даёт q = 3.01, f = 12.04. Прирост 0.04 равен 4 · 0.01.
На пальцах. Пусть f = a · a при a = 3, то есть f = 9. Узел × видит два входа, и оба равны a.
По первому входу local равен второму множителю, 3; по второму равен первому, тоже 3.
Правильный градиент это сумма: 3 + 3 = 6, как и (a²)' = 2a = 6.
Если второй вклад перезаписал первый, выйдет 3. Ошибка вдвое, и никакого исключения.
- Градиенты складываются на разветвлениях
- Интуиция узлов:
+раздаёт градиент,maxмаршрутизирует в один вход,×меняет коэффициенты местами - Обратный топологический порядок. Топологический порядок такой, где каждый узел стоит после всех своих входов; обратный идёт от лосса к входам, чтобы к узлу успели прийти все вклады
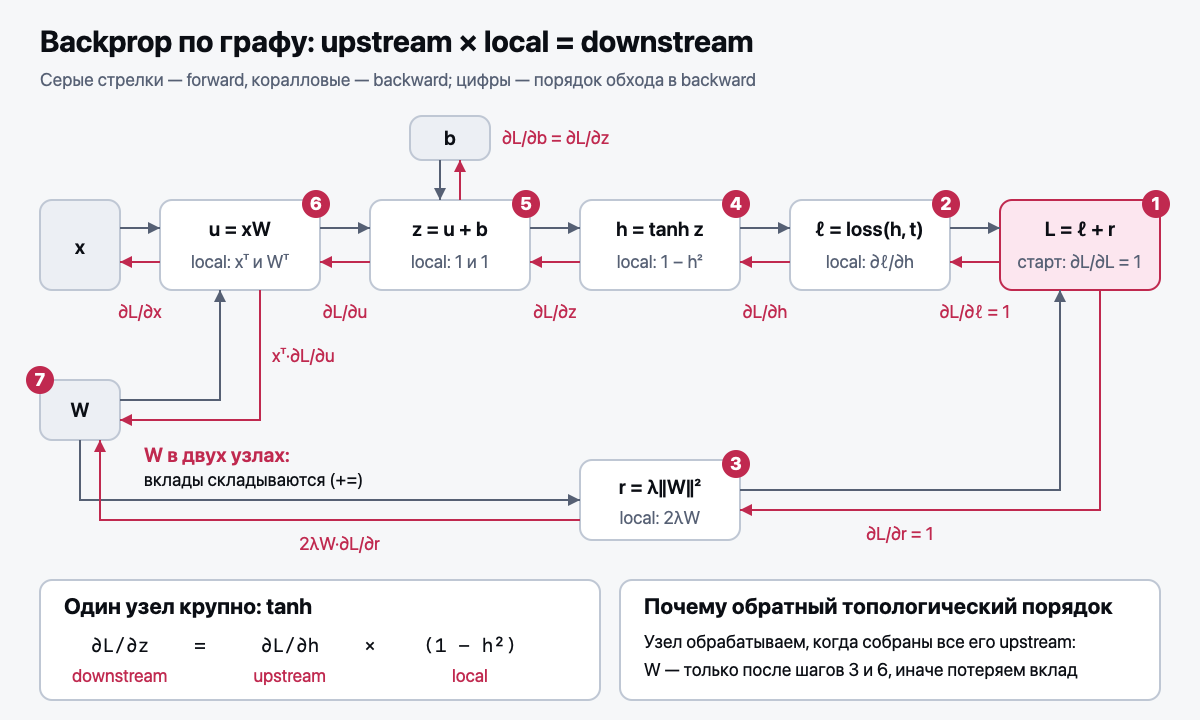
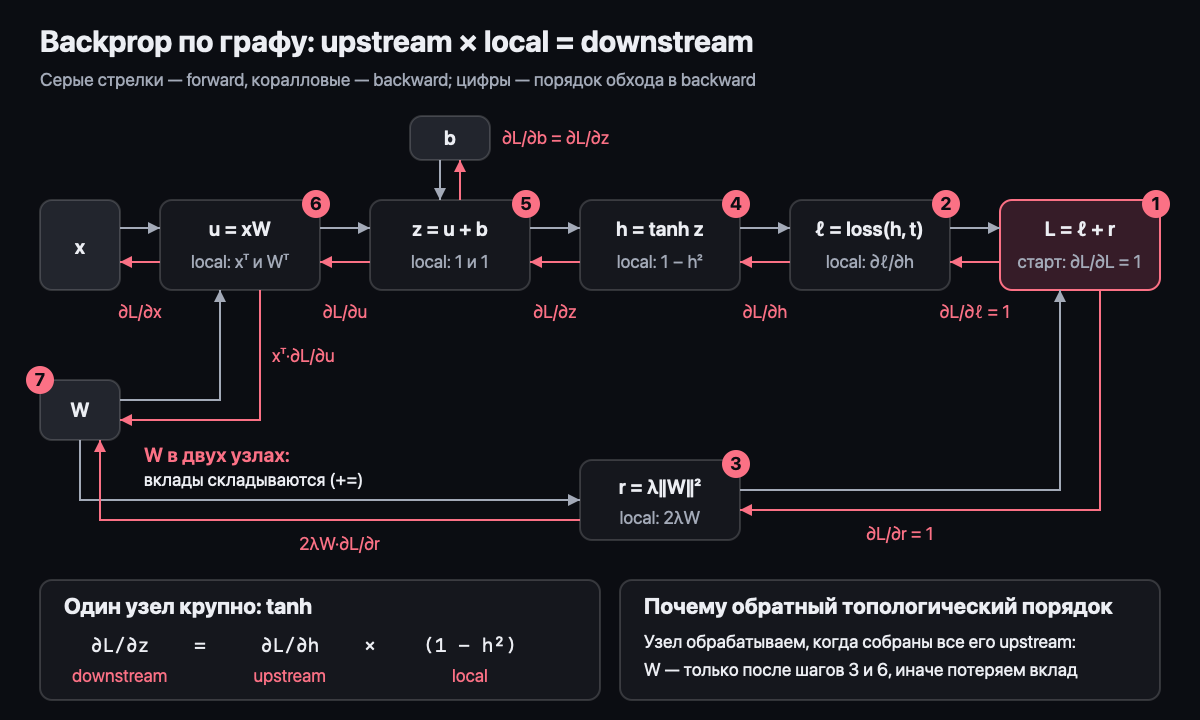
- Сложность forward и backward одного порядка
- Автодифференцирование: каждый тип узла знает свой локальный градиент
- Gradient checking (проверка градиента численно):
f'(x) ≈ (f(x+h) − f(x−h)) / 2h
На пальцах. У сети миллион весов. Численный градиент сдвигает каждый вес по очереди в обе стороны:
это 2·10⁶ прогонов forward на один шаг. Backward выдаёт все миллион производных за один проход,
по цене примерно двух forward: каждый узел один раз умножает upstream на свой local.
Поэтому численный градиент нужен только для проверки на крошечной сети, а учат backprop'ом.
- Прямой и обратный режим автодифференцирования. Прямой (forward mode) несёт производные вместе с forward, от входа к выходу: один проход даёт производные всех выходов по одному входу (Якобиан на вектор, JVP). Обратный (reverse mode; именно его называют backprop) идёт от выхода к входам: один проход даёт производные одного выхода по всем входам (вектор на Якобиан, VJP). У обучения выход один (скалярный лосс), а входов миллиарды, поэтому выбран обратный режим. Его цена: активации forward надо хранить до backward
На пальцах. Сеть из 100 слоёв. Обычный backward держит в памяти все 100 активаций.
Checkpointing сохраняет каждую десятую, всего 10 штук. В backward отрезок из 10 слоёв пересчитывается
заново от ближайшей сохранённой точки, и в памяти временно ещё 10 его активаций.
Пик 10 + 10 = 20 вместо 100, а цена примерно ещё один forward.
При 5 точках было бы 5 + 20 = 25, при 20 точках 20 + 5 = 25: минимум ровно при √100 = 10.
- Activation checkpointing (хранить часть активаций, остальные пересчитывать в backward): память
O(N)→O(K + N/K), оптимум приK=√N→ памятьO(√N), вычисления в backward околоO(2N) - Почему
.backward()требует скаляр:∂L/∂θэто одно число на параметр - Градиент от mean-loss = mean градиентов (линейность производной)
На пальцах. Модель предсказала ŷ = 2, правда y = 3. Допустим, правда равна прогнозу плюс гауссов шум
(случайная добавка с колоколообразным распределением) с дисперсией 1. Плотность такого исхода e^{−(y−ŷ)²/2} / √(2π),
её минус логарифм (y − ŷ)²/2 + ½·ln 2π ≈ 0.5 + 0.919. Второе слагаемое от модели не зависит,
поэтому минимизировать отрицательное лог-правдоподобие значит минимизировать квадрат ошибки.
Производная по ŷ равна ŷ − y = −1: прогноз минус правда, ровно как p − one_hot(t) ниже.
- Функция потерь как NLL (negative log-likelihood, отрицательное лог-правдоподобие: минус логарифм
вероятности, которую модель дала правильному ответу). Регрессия с гауссовым шумом даёт MSE, категориальный
выход даёт кросс-энтропию, Бернулли даёт бинарную кросс-энтропию (Модуль 0, F6). Предположение о шуме
выбирает лосс: шум Лапласа (с тяжёлыми хвостами) дал бы
|y − ŷ|, то есть MAE, устойчивую к выбросам - Почему не учить прямо по accuracy (доле верных ответов): она ступенчатая. Малый сдвиг весов её не меняет, и градиент почти везде равен нулю. Лосс берут гладким и дифференцируемым, метрику считают отдельно
На пальцах. Три класса, логиты z = (0.69, 0, 0). Так как e^0.69 ≈ 2, softmax даёт
p = (2, 1, 1) / 4 = (0.5, 0.25, 0.25). Правильный класс второй, лосс −ln 0.25 ≈ 1.386.
Формула ниже обещает градиент p − one_hot(t) = (0.5, −0.75, 0.25).
Проверим второй логит: поднимем его на 0.01, тогда p₂ станет 0.2519, лосс 1.3788. Лосс упал на 0.0075 = 0.75 · 0.01.
Знак и множитель совпали. Спуск тянет правильный логит вверх с силой 1 − p_t, остальные вниз с силой своей вероятности.
Ключевой вывод недели. Сделать руками: это спрашивают постоянно:
Градиент softmax + cross-entropy:
  ∂L/∂z = p − one_hot(t)
Путь: ∂L/∂p (ненулевой только в t) → Якобиан softmax
(p_j(1−p_j) на диагонали, −p_j p_i вне) → всё схлопывается.
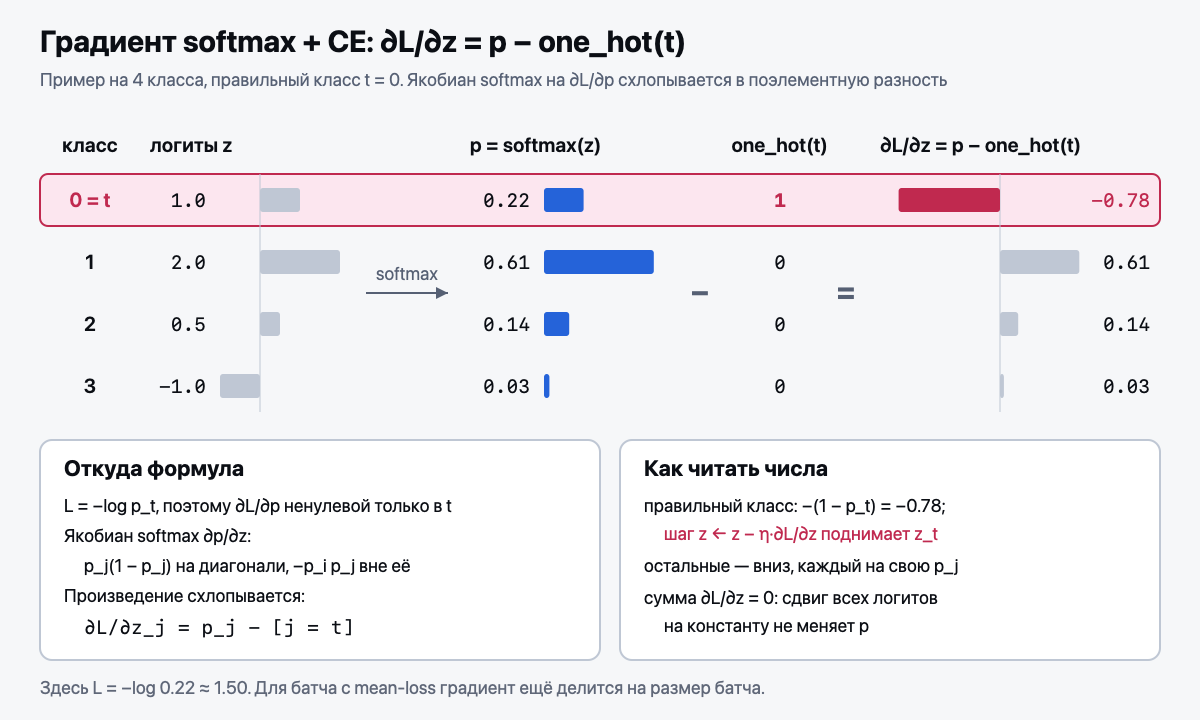
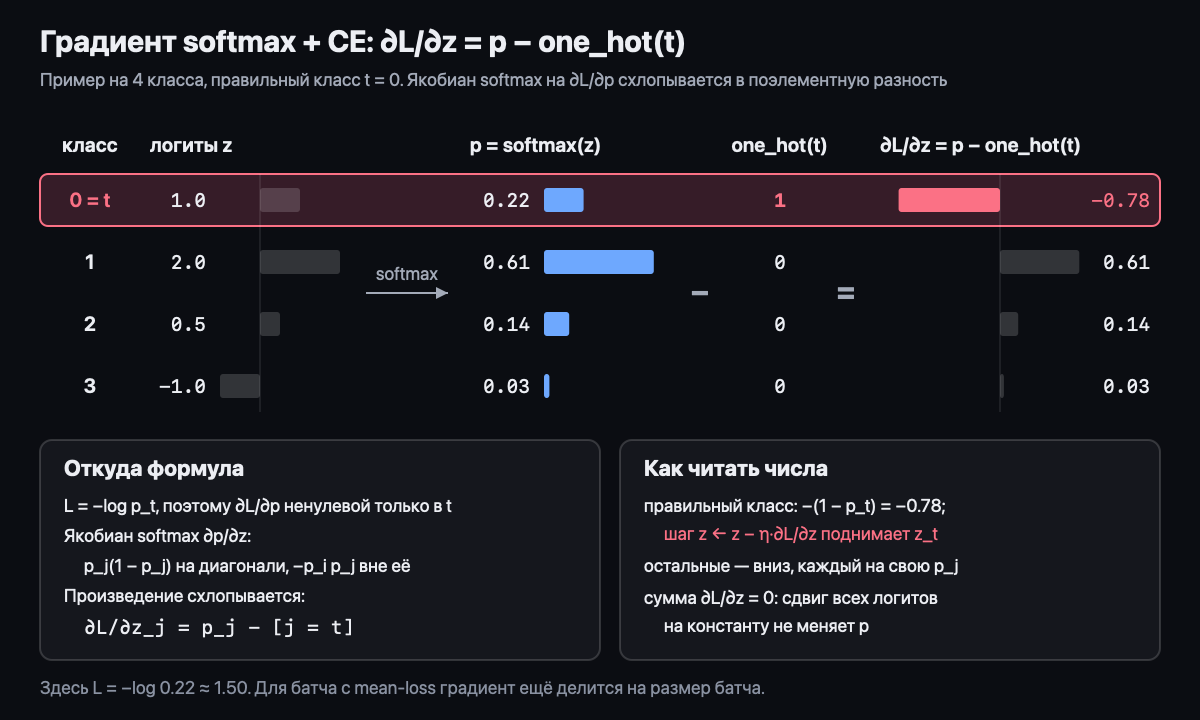
Код → nanolm/autograd.py: свой autograd-движок (micrograd-стиль): Value
со скаляром, градиентом и ссылками на родителей; операции + * tanh exp pow, каждая
знает свой локальный градиент; .backward() строит топологическую сортировку графа
и проходит её в обратном порядке. Затем Neuron, Layer, MLP поверх Value
и обучение на XOR. Задание: exercises/autograd.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_autograd.py -v.
На что смотреть в тестах: узел, использованный дважды (a * a, a + a), обязан
получить сумму градиентов: это правило разветвления из теории выше. Если градиент
перезаписывается вместо +=, упадёт test_reused_variable_accumulates_gradient.
Ромбовидный граф (test_diamond_graph_needs_topological_order) ловит обход без
топологической сортировки, а случайные выражения сверяются с PyTorch.
Математика (трек D): Uniform, Exponential, Gaussian. Свойство отсутствия памяти (geometric и exponential, единственные memoryless-распределения).
Интервью-вопрос недели: «Выведи градиент softmax + cross-entropy по логитам». Спрашивают
дословно. Структура на 3 минуты: (1) ответ первым: ∂L/∂z = p − one_hot(t); (2) путь: ∂L/∂p ненулевой
только в t и равен −1/p_t → строка t Якобиана softmax (p_t(1−p_t) на диагонали, −p_t p_j вне) →
после умножения остаётся p_j − [j = t]; (3) смысл: правильный логит тянется вверх с силой 1 − p_t,
остальные вниз с силой p_j, сумма градиента равна нулю; (4) цифра: z = (0.69, 0, 0), верный класс второй →
(0.5, −0.75, 0.25); поднять второй логит на 0.01, и лосс падает на 0.0075; (5) жди «почему в коде это одна
функция от логитов, а не softmax, потом log». Ответ: log_softmax через logsumexp (неделя 4), без деления
на крошечное p_t.
Глубже: 05-ГЛУБИНА, раздел «Недели 1–4, трек D. Математика: большой недобор».
Результаты недели
- Могу вывести
∂L/∂z = p − one_hot(t)для softmax + CE через Якобиан softmax за 5 минут. - Могу реализовать
Value-autograd с топологической сортировкой и обучить на нём MLP. - Могу показать на графе, почему градиенты на разветвлении складываются, и найти этот баг в чужом коде.
- Могу посчитать память и вычисления при activation checkpointing и вывести оптимум
K = √N.
Самопроверка
- Почему backward идёт в обратном топологическом порядке и что сломается при другом порядке?
- Как узлы
+,×иmaxраспределяют градиент в обратном проходе? - Почему проверка градиента использует центральную разность и почему в float64?
- Почему MSE это отрицательное лог-правдоподобие гауссианы и почему нельзя учить модель прямо по accuracy?
- Сколько прогонов forward стоит численный градиент для
Nвесов и почему для обучения нужен обратный режим, а не прямой?