Неделя 1. Нейросети и градиенты
Учиться в приложении: тьютор, задачи с кодом →
Ядро: MLP и формы тензоров, якобианы и цепное правило, функции активации, MLP на numpy с backward · Глубина: распределения и ожидание (трек D) · ≈ 10 ч ядро / 20 ч всё
Всё, что дальше делает модель, сводится к матричным умножениям, нелинейностям и градиентам по ним. Если здесь формы и Якобианы не станут автоматическими, каждая следующая неделя (backprop, внимание, LoRA) превратится в угадывание, где транспонировать. Неделя ставит один навык: вывести градиент слоя на батче и проверить его по форме.
Теория
- MLP (многослойный перцептрон: слои «линейное преобразование → нелинейность» подряд):
нейрон =
f(wᵀx + b), слой =H = f(XW + b) - Батч-измерение: почему PyTorch хранит
Wкак(n_out, n_in)и транспонирует. Транспонирование бесплатно: меняется только stride (шаг в памяти между соседними элементами по оси), данные не копируются. А градиент∂L/∂Wсразу выходит нужной формы - Функции активации: sigmoid, tanh, softmax (+ температура), ReLU, LeakyReLU, Swish (
x·σ(x)), GLU (выход одной проекции, умноженный на гейт от другой), SwiGLU
На пальцах. Слой «умножь на 2», за ним слой «умножь на 3»: вместе это один слой «умножь на 6».
Сколько линейных слоёв ни ставь подряд, в сумме выйдет одна матрица. Нелинейность это ломает.
ReLU(x) − ReLU(x − 1) равна 0 при x = −1, 0.5 при x = 0.5 и 1 при x = 2.
Это ступенька, а ни одна прямая ступеньку не нарисует.
- Почему без нелинейностей глубина бесполезна:
W₁W₂x = Wx
На пальцах. Производная сигмоиды нигде не больше 0.25. В backward через каждый слой с сигмоидой
градиент умножается на σ', то есть в лучшем случае на 0.25. Через 10 таких слоёв остаётся
0.25¹⁰ ≈ 10⁻⁶ от исходного сигнала. Первые слои почти не учатся.
- Проблемы: vanishing gradients (затухание градиента) у sigmoid (
σ' ≤ 0.25), не-zero-centered выход (выход сигмоиды всегда положителен, и градиенты всех входных весов нейрона получаются одного знака), dying ReLU (нейрон ушёл туда, где на всех входах выдаёт 0, и градиент к нему больше не приходит)
На пальцах. Функция из двух чисел в два: f(x, y) = (x·y, x + y²). В точке (2, 3) она выдаёт (6, 11).
Сдвинем x на 0.01: выход станет (6.03, 11.01), прирост (0.03, 0.01).
Сдвинем y на 0.01: выход (6.02, 11.0601), прирост (0.02, 0.0601).
Поделим приросты на шаг: столбец по x равен (3, 1), столбец по y равен (2, 6.01).
Лишние 0.01 появились из-за квадрата: это вклад 0.01²; при меньшем шаге они исчезают.
Получилась таблица [[3, 2], [1, 6]]. Это и есть Якобиан: каждая строка отвечает одному выходу, каждый столбец одному входу.
Формулой: J = [[y, x], [1, 2y]].
- Градиент (вектор производных скалярной функции по всем входам), Якобиан (m×n: производная каждого
из
mвыходов по каждому изnвходов), Гессиан (n×n, вторые производные, то есть кривизна ландшафта потерь) - Цепное правило: для многомерных функций это перемножение Якобианов
- Якобиан поэлементной функции =
diag(f'(z)): выходiзависит только от входаi, поэтому вне диагонали нули
Вывести на бумаге (обязательно)
∂/∂x (Wx+b) = W,∂/∂b (Wx+b) = I,∂/∂u (uᵀh) = hᵀ- Производную сигмоиды через частное:
σ' = σ(1−σ) - Производную Swish через произведение:
σ(x) + Swish(x)(1−σ(x))
На пальцах. Один вес w = 3, батч из двух чисел x = (1, 2), выходы zᵢ = w·xᵢ,
лосс L = z₁ + z₂ = 9. Сдвинем w на 0.01: сдвинутся оба выхода, и L вырастет на 0.01·(1 + 2).
Значит, ∂L/∂w = 1 + 2 = 3: вклады примеров сложились в одно число, ведь и сам w один на батч.
Сдвинем только x₁: изменится только z₁, поэтому ∂L/∂x₁ = 3. Так же ∂L/∂x₂ = 3.
Итог (3, 3): по числу на пример, той же формы, что x.
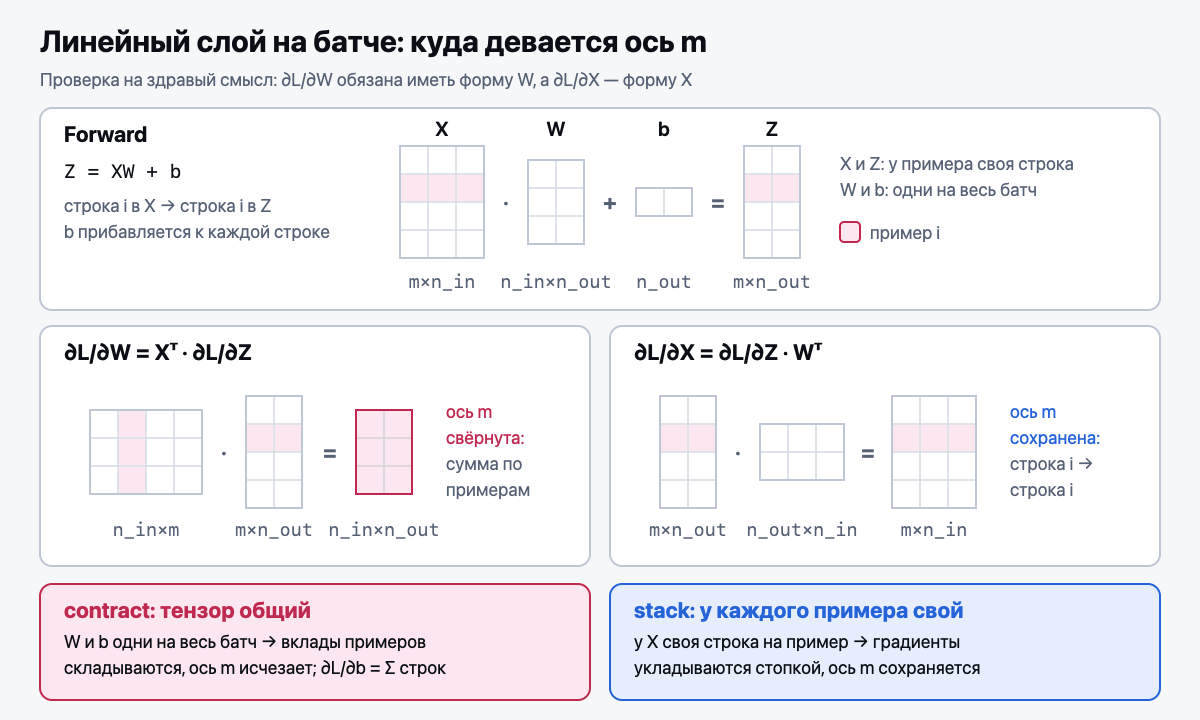
Как не путаться в формах при батче. Выводи Якобиан для одного примера: там всё двумерно и очевидно. Дальше вопрос только в том, куда девается батчевая ось, и ответ следует прямо из того, сколько раз тензор участвует в вычислении:
Wодин на весь батч, каждый пример даёт свой вклад в∂L/∂W→ вклады складываются, батчевая ось исчезает (свёртка по ней внутри матмула).Xу каждого примера свой, строкиZне смешиваются между примерами → градиенты просто укладываются стопкой, батчевая ось сохраняется.
Проверка на здравый смысл: ∂L/∂W обязана иметь форму W, а ∂L/∂X обязана иметь форму X.
Если получилось иначе, ось потеряна или лишняя.
Код (трек B): MLP на голом numpy: forward и backward вручную, без autograd.
Проверить численным градиентом (разностью (f(w+h) − f(w−h)) / 2h по каждому весу).
Математика (трек D): Bernoulli, Binomial, Poisson, Geometric. Вывести E[X] и Var[X] для каждого.
Приём: X² = X для индикаторов. Приём: разложить на Бернулли и использовать линейность.
LeetCode: массивы, хеш-таблицы, два указателя (3 задачи по списку трека C).
Интервью-вопрос недели: «Выведи градиенты линейного слоя Z = XW + b на батче. Какой формы
∂L/∂W и ∂L/∂X?» Структура на 3 минуты: (1) первым назови формы: X это (m, n), W это (n, k),
Z это (m, k); (2) вывод на одном примере, где всё двумерно, потом один вопрос: куда девается
батчевая ось; (3) главный вывод: W один на батч → вклады складываются, ∂L/∂W = Xᵀ·∂L/∂Z;
X у каждого примера свой → стопка, ∂L/∂X = ∂L/∂Z·Wᵀ; ∂L/∂b это сумма по батчу; (4) проверка:
градиент обязан иметь форму своего тензора, плюс численный градиент центральной разностью,
относительная ошибка < 1e-6 в float64; (5) жди уточнения «почему PyTorch хранит W как (n_out, n_in)». Ответ:
транспонирование бесплатно, меняется только stride.
Глубже: 05-ГЛУБИНА, раздел «Недели 1–4, трек D. Математика: большой недобор».
Результаты недели
- Могу вывести на бумаге
∂(Wx+b)/∂x,∂/∂W,∂/∂b, производные сигмоиды и Swish за 10 минут без подсказок. - Могу по формам сказать, где батчевая ось суммируется (
∂L/∂W), а где сохраняется (∂L/∂X), и проверить результат по форме. - Могу реализовать MLP на numpy с ручным backward и подтвердить его численным градиентом (относительная ошибка < 1e-6 в float64).
- Могу за 2 минуты объяснить, почему без нелинейности глубина бесполезна и почему сигмоида ведёт к затуханию градиента.
Самопроверка
- Почему для батча
∂L/∂Wэто сумма вкладов примеров, а∂L/∂Xстопка? Назови формы обоих. - Чему равен Якобиан поэлементной функции и почему он диагональный?
- Три проблемы сигмоиды в скрытом слое, что из них решает ReLU и какая проблема появляется у ReLU?