Неделя 16. RL: от REINFORCE до PPO
Учиться в приложении: тьютор, задачи с кодом →
Ядро: policy gradient с выводом, baseline без смещения, importance sampling, PPO и клиппинг · Глубина: GAE в деталях, генеративные модели за пределами авторегрессии (05-ГЛУБИНА) · ≈ 12 ч ядро / 23 ч всё
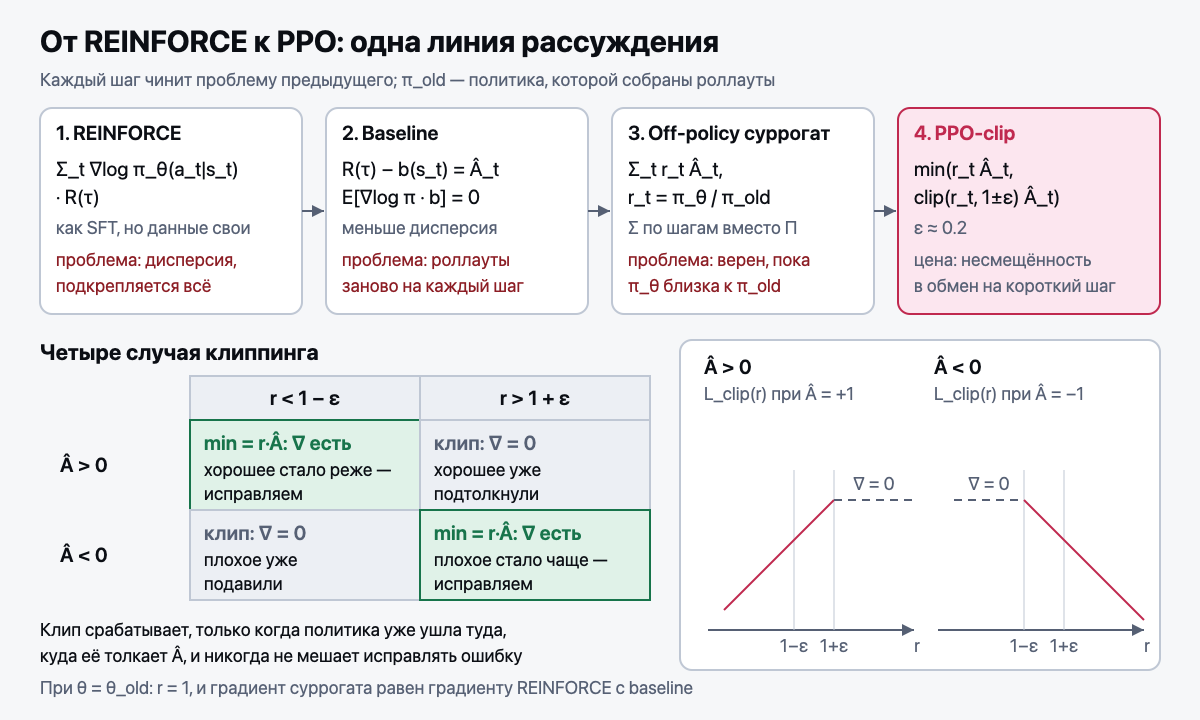
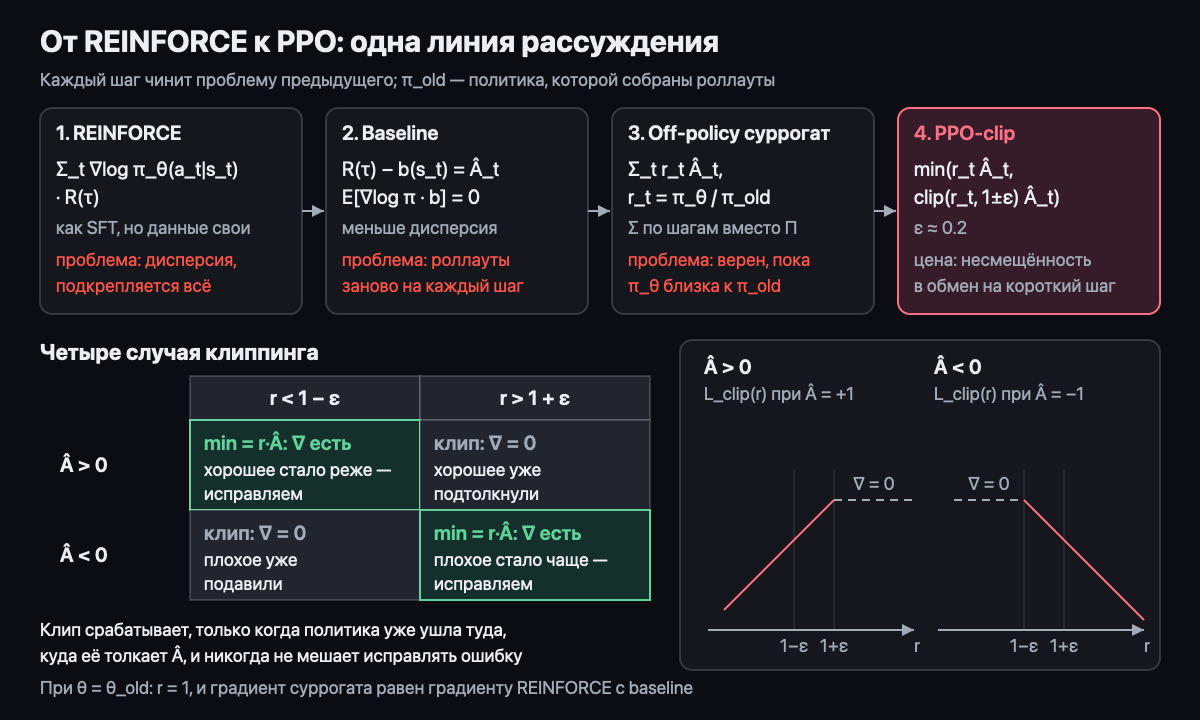
Порядок здесь важнее содержания. Обычно рассказывают REINFORCE, потом сразу PPO, и клиппинг выглядит произвольным трюком, который заучивают. Между ними есть промежуточный шаг, и с ним вся линия становится одним рассуждением.
Шаг 1. Policy gradient
На пальцах. Бандит с тремя ручками A, B, C: одно действие, никаких состояний.
Политика равна softmax(θ); на старте θ = (0, 0, 0) и π = (⅓, ⅓, ⅓). Выпала ручка A, награда R = 1.
Градиент ∇θ log π(A) = one_hot(A) − π = (⅔, −⅓, −⅓), ровно тот, что дала бы кросс-энтропия с меткой A.
REINFORCE делает шаг θ ← θ + η·R·(⅔, −⅓, −⅓). При η = 1 выходит θ = (0.67, −0.33, −0.33),
и π(A) вырастает с 0.33 до 0.58. Это SFT на собственном сэмпле, умноженный на награду.
При награде 0 шага нет, при отрицательной шаг идёт от A.
- MDP (марковский процесс принятия решений: состояние, действие, награда, переход), policy (распределение над действиями в данном состоянии), value (ожидаемая будущая награда из состояния), advantage (насколько действие лучше среднего в этом состоянии). LLM как policy над токенами: действие это следующий токен, состояние это уже написанный префикс
- Вывести теорему руками через log-derivative trick:
∇P = P∇log P - REINFORCE. Заметить, что это то же обновление, что и в SFT, только данные сэмплированы самой политикой, а градиент взвешен наградой
Дисконт γ (множитель от 0 до 1: во сколько раз награда дешевеет за каждый шаг ожидания).
На пальцах. γ = 0.9. Награда 1 сейчас стоит 1, через шаг 0.9, через 3 шага 0.9³ ≈ 0.73, через 10 шагов 0.9¹⁰ ≈ 0.35.
Как в экономике: рубль через год стоит меньше рубля сегодня. Теперь ответ LLM из 500 токенов с одной наградой в самом конце.
При γ = 0.99 до первого токена дойдёт 0.99⁵⁰⁰ ≈ 0.007 от неё: сигнал почти исчез.
Формула: отдача (return, сумма будущих наград) G_t = r_t + γ·r_{t+1} + γ²·r_{t+2} + … = Σ_k γ^k·r_{t+k}, value V(s) = E[G_t | s_t = s].
В классическом RL γ < 1 нужен, чтобы бесконечная сумма сходилась, а близкая награда ценилась выше дальней.
У LLM эпизод конечный и награда одна, поэтому в RLHF и RLVR обычно γ = 1: каждый токен ответа получает одну итоговую оценку.
λ в GAE (шаг 2) другой множитель: он не про цену будущего, а про смесь горизонтов в оценке advantage.
Уравнение Беллмана и итерация по ценности. Value из формулы выше подчиняется простому правилу: ценность
состояния равна награде за ближайший шаг плюс дисконтированная ценность того места, куда этот шаг приведёт.
На пальцах. Два состояния, s₁ и s₂, γ = 0.9. В s₁ можно «остаться» (награда 1, остаёмся в s₁)
или «перейти» (награда 0, попадаем в s₂). В s₂ действие одно: награда 2, остаёмся в s₂.
Начинаем с V = (0, 0) и каждый раз подставляем старые ценности в правую часть.
Итерация 1: V(s₁) = max(1 + 0.9·0, 0 + 0.9·0) = 1, V(s₂) = 2 + 0.9·0 = 2; выгоднее остаться.
Итерация 2: V(s₁) = max(1 + 0.9·1, 0 + 0.9·2) = max(1.9, 1.8) = 1.9, V(s₂) = 2 + 0.9·2 = 3.8; всё ещё остаться.
Итерация 3: max(1 + 0.9·1.9, 0.9·3.8) = max(2.71, 3.42): теперь выгоднее перейти. Ценность s₂ «дотекла» до s₁,
и жадная политика поменялась. В пределе V(s₂) = 2/(1 − 0.9) = 20 и V(s₁) = 0.9·20 = 18, а «остаться навсегда» дало бы только 10.
Формулы: Q(s, a) = R(s, a) + γ·Σ_s' P(s'|s, a)·V(s') (ценность действия: награда за него плюс дисконтированная
ценность продолжения), V(s) = max_a Q(s, a) (уравнение оптимальности Беллмана), жадная политика π(s) = argmax_a Q(s, a).
За одну итерацию наибольшая ошибка V умножается не больше чем на γ (обновление сжимающее), поэтому при γ < 1
итерация сходится из любого начального V.
Для фиксированной политики π уравнение то же, но без максимума: V^π(s) = Σ_a π(a|s)·Q^π(s, a).
Связь с PPO. Value head учится именно по этому уравнению для текущей политики, а не для оптимальной, и учится по сэмплам:
перебрать все состояния (префиксы) невозможно, а награду мы видим только на роллаутах.
Невязка Беллмана на одном шаге δ_t = r_t + γ·V(s_{t+1}) − V(s_t) в среднем равна advantage
A(s_t, a_t) = Q(s_t, a_t) − V(s_t), если V точная: это оценка advantage на горизонте в один шаг.
GAE (шаг 2) складывает такие δ с весами (γλ)^k.
В тренажёре это задача value_iteration: там те же обозначения в виде массивов, P[s, a, s2], R[s, a], gamma.
Шаг 2. Baseline, с доказательством несмещённости
На пальцах. Тот же бандит, но награды всегда положительные: A = 3, B = 2, C = 1. Выпала худшая ручка C.
REINFORCE без baseline толкает её вверх: шаг 1 · (−⅓, −⅓, ⅔).
Вычтем baseline b = 2, среднюю награду. Множитель стал 1 − 2 = −1, и C толкают вниз.
Среднее направление шага при этом не изменилось: в обоих случаях (⅓, 0, −⅓).
Изменился разброс: суммарная дисперсия оценки градиента падает с 2.89 до 0.22, в 13 раз.
- Проблема без baseline: на лёгком промпте все ответы получают положительную награду, подкрепляются все, включая плохие
- Доказать, что вычитание
b(s_t)не вносит смещения. Три строки: вынестиbза матожидание по действию (можно, потому чтоbзависит только от состояния), применить log-derivative trick в обратную сторону, получить∇Σπ(a|s) = ∇1 = 0 - Связь с advantage:
R(τ) − V(s_t)это Монте-Карло оценкаA(s,a) - Варианты baseline: обученная value-функция (PPO), среднее по остальным ответам группы (RLOO), среднее по батчу (REINFORCE++)
- GAE (оценка advantage как взвешенная смесь оценок на разные горизонты; вес задаёт
λ)
Шаг 3. Off-policy и importance sampling: то самое недостающее звено
На пальцах. Роллаут (сгенерированный ответ) собран старой политикой. На одном токене π_old = 0.2,
а новая политика даёт 0.3, отношение 1.5. Честный перенос требует перемножить такие отношения по всем токенам ответа.
Если на каждом из 100 токенов отношение 1.05, произведение 131; если 0.95, то 0.006.
Почти одинаковые политики дают вес от «почти ноль» до «больше ста».
Поэтому суррогат берёт отношения по шагам по отдельности и складывает.
- Проблема on-policy (данные собирает та же политика, которую обучаем): перед каждым шагом градиента надо генерировать заново, хотя политика почти не менялась
- Importance sampling (перевзвешивание сэмплов одного распределения, чтобы оценивать среднее по другому): учимся на роллаутах от
π_oldс перевесомr_t = π_θ(a_t|s_t) / π_old(a_t|s_t) - Ключевой момент: честный перенос даёт произведение отношений по траектории, у которого катастрофическая дисперсия. Поэтому берут суррогатную цель, где произведение заменено суммой по шагам. Это уже другая цель, а не переписанная исходная
Шаг 4. PPO теперь очевиден
На пальцах. ε = 0.2: отношение r зажимается в [0.8, 1.2], и берётся min(r·Â, clip(r)·Â).
 = +2, r = 1.5: хорошее действие уже подняли больше чем на 20%. min(3.0, 2.4) = 2.4: это константа, градиента нет.
 = +2, r = 0.7: хорошее действие стало реже: это ошибка. min(1.4, 1.6) = 1.4, градиент идёт, ошибку исправляют.
 = −2, r = 0.7: плохое уже опустили больше чем на 20%. min(−1.4, −1.6) = −1.6, константа, стоп.
 = −2, r = 1.5: плохое стало чаще. min(−3.0, −2.4) = −3.0, градиент идёт.
- Суррогат корректен, только пока
π_θнедалеко ушла отπ_old. Клиппинг это и есть ограничение на уход, ценой отказа от несмещённости - Разобрать все четыре случая клиппинга и обнаружить, что оно несимметрично: срабатывает, только когда политика движется туда, куда её толкает advantage, и никогда не мешает исправлять ошибку
- Value head (голова модели, предсказывающая value), KL-штраф (наказание за отход от референсной политики), несколько эпох на одном батче
Код → nanolm/rl.py: reinforce_loss, mean_baseline, rloo_baseline,
surrogate_loss, ppo_clip_loss, clip_diagnostics.
Проверка себя: NANOLM_IMPL=exercises pytest tests/test_rl.py -v.
Ключевой тест недели test_surrogate_reduces_to_reinforce_at_theta_old:
при θ = θ_old градиенты суррогата и REINFORCE обязаны совпасть. Зелёный тест
означает, что цепочка «policy gradient → off-policy → PPO» у тебя не разорвана.
Отдельно запусти python scripts/rl_demo.py: там снижение дисперсии
от baseline измерено численно, а не заявлено словами.
Математика (трек D): D23: несмещённость baseline и оптимальная константа; D24: дисперсия importance sampling.
Интервью-вопрос недели: «Откуда в PPO клиппинг? Выведи от policy gradient.» Структура на 3 минуты:
(1) первым идёт log-derivative trick: ∇E[R] = E[R·∇log π]; REINFORCE это SFT на собственном сэмпле,
умноженный на награду; (2) baseline: вычитание b(s) не вносит смещения (три строки, ∇Σπ = ∇1 = 0),
а дисперсию снижает, в примере с бандитом с 2.89 до 0.22; (3) off-policy: честный перенос это произведение
отношений, при 1.05 на каждом из 100 токенов это 131, при 0.95 это 0.006; суррогат с суммой по шагам
уже другая цель, верная, пока π_θ рядом с π_old; (4) вывод: клиппинг r в [1 − ε, 1 + ε] и есть
ограничение на этот уход; правило из четырёх случаев: градиент обнуляется, только когда политика уже
ушла туда, куда толкает Â, исправлять ошибку клиппинг не мешает; (5) жди «зачем тогда KL-штраф»:
клиппинг держит рядом с π_old на одном батче, KL держит рядом с референсной моделью за всё обучение.
Глубже: 05-ГЛУБИНА, разделы «★★ Недели 16–17. Недостающее звено между REINFORCE и PPO» и «★★ Недели 16 и 20. Генеративные модели за пределами авторегрессии».
Результаты недели
- Могу вывести policy gradient через log-derivative trick на бумаге за 5 минут.
- Могу доказать несмещённость baseline в три строки.
- Могу разобрать все четыре случая клиппинга PPO и сформулировать правило одной фразой.
- Могу реализовать
ppo_clip_lossи пройтиtest_surrogate_reduces_to_reinforce_at_theta_old. - Могу записать уравнение Беллмана, сделать две итерации по ценности на маленьком MDP руками и показать, где невязка Беллмана появляется в GAE.
Самопроверка
- Почему в суррогатной цели сумма отношений по шагам, а не произведение, и чем за это платят?
- В каком случае клиппинг не срабатывает и почему это правильно?
- Чем baseline RLOO отличается от value-функции PPO по стоимости и по дисперсии?
- Запиши уравнение Беллмана для
V^πи для оптимальнойV. По какому из них учат value head в PPO и как из невязки Беллмана получается оценка advantage?