Неделя 15. SFT и данные
Учиться в приложении: тьютор, задачи с кодом →
Ядро: SFT и маскирование лосса, чат-шаблоны, LoRA и QLoRA, дедупликация и фильтры данных · Глубина: дистилляция и прунинг, лаборатория данных 15b · ≈ 11 ч ядро / 21 ч всё
С этой недели модель не предобучают, а доводят: предобученная LLM продолжает текст, а не отвечает на вопросы. SFT это первый этап post-training, и RL недель 16–17 стартует с SFT-модели. Здесь же два инструмента, без которых дообучение не помещается в бюджет, а бенчмарк ничего не доказывает (неделя 18): LoRA и чистые данные с деконтаминацией.
- Instruction tuning (SFT, дообучение на парах «инструкция → ответ»), чат-шаблоны (формат, склеивающий диалог в одну строку), спецтокены ролей (отмечают, где реплика пользователя, а где ассистента)
На пальцах. Пример: <user> Сколько будет 2 + 2? <assistant> 4 <end>. Пусть это 8 токенов промпта и 2 токена ответа.
Без маски лосс считается на всех позициях, и около 80% сигнала уходит на предсказание вопроса пользователя.
Модель учится писать как пользователь, а не отвечать. С маской метки промпта заменены на ignore_index (−100),
и лосс считается только там, где предсказываются 4 и <end>.
При длинных промптах перекос сильнее: документ на 900 токенов и ответ на 100: без маски на ответ пришлось бы 10% градиента.
- Маскирование лосса на промпте, и почему без этого модель учится не тому
На пальцах. Учитель на вопрос «столица Австралии?» выдаёт распределение: Канберра 0.7, Сидней 0.2, Мельбурн 0.1.
One-hot-метка сообщает только «Канберра». Мягкая метка добавляет больше: Сидней это правдоподобная ошибка, Мельбурн менее правдоподобная.
Ученик, обученный на (0.7, 0.2, 0.1), получает больше информации с одного примера.
Лосс здесь кросс-энтропия с распределением учителя, и log softmax ученика считают через logsumexp (неделя 4).
- Синтетические данные, дистилляция (ученик учится на выходах учителя; в т.ч. по логитам;
тут как раз всплывает нестабильность
logsumexp) - Курирование данных: дедупликация (MinHash/LSH), фильтры качества, деконтаминация (удаление из обучения текстов, пересекающихся с тестовыми наборами)
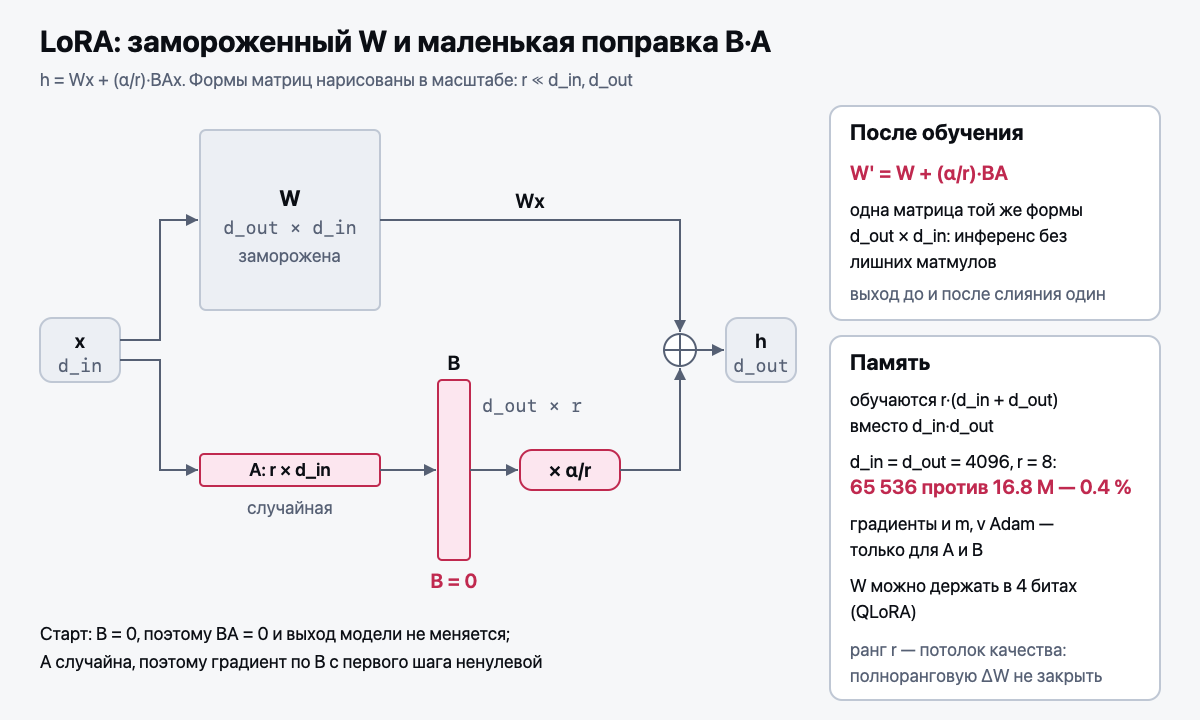
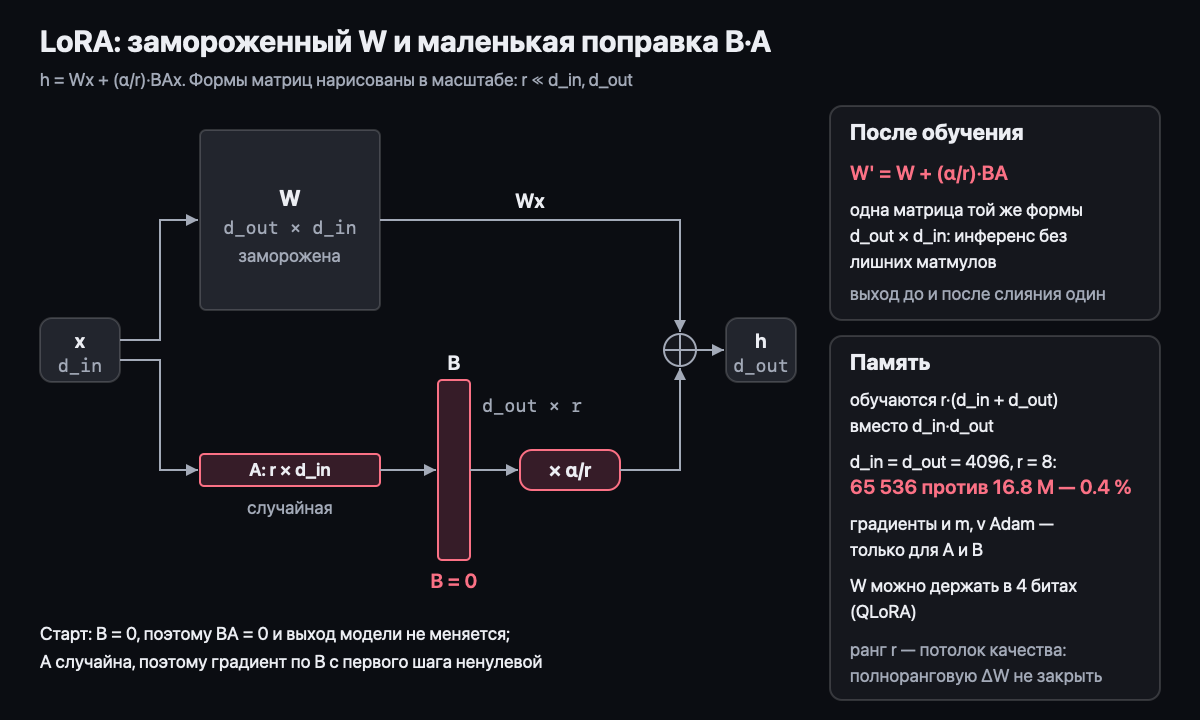
На пальцах. Матрица слоя W размером 4096×4096 содержит 16.8 млн чисел, её не трогают.
Поверх кладут поправку ΔW = B·A: B размером 4096×8, A размером 8×4096, вместе 65 536 чисел, 0.4% от W.
Поправка ограничена по форме. Ранг 1 это b·aᵀ: при b = (1, 2) и a = (3, 0, 1) выходит
[[3, 0, 1], [6, 0, 2]], и вторая строка обязана быть кратной первой.
Ранг 8 это не больше 8 независимых направлений правки на весь слой.
Этого хватает, если нужная правка почти низкоранговая, и не хватает, если нет.
- LoRA / QLoRA: низкоранговое разложение (поправка весов как произведение двух узких матриц), где вставлять адаптеры, что экономит память. QLoRA это то же поверх замороженной модели, сжатой до 4 бит (квантование, подробно в неделе 14)
Код → nanolm/lora.py: LoRALinear, apply_lora, mark_only_lora_trainable,
merge_lora, parameter_summary. Задание в exercises/lora.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_lora.py -v.
Проверь три вещи руками: на старте выход модели не меняется (B инициализирован
нулями); после mark_only_lora_trainable у замороженных параметров .grad
остаётся None; слияние не меняет выход.
И отдельно test_lora_quality_is_bounded_by_rank: ранг это потолок, а не
«побольше, значит лучше». Если ΔW полноранговая, низкий ранг её не закроет никогда.
Код → nanolm/compress.py: magnitude_prune (прунинг, то есть обнуление самых маленьких весов:
глобальный и послойный), prune_ffn_neurons (удаление нейронов SwiGLU целиком, матрицы становятся уже),
low_rank_approximate через SVD (разложение по сингулярным числам), distillation_loss с температурой
и множителем T². Задание в exercises/compress.py, проверка: NANOLM_IMPL=exercises pytest tests/test_compress.py -v.
Дистилляция из списка выше здесь в коде: при alpha = 0 лосс равен обычной кросс-энтропии, а без множителя T²
градиент мягкой части падал бы как 1/T². Ошибка низкого ранга совпадает с теоремой Эккарта–Янга.
Код → nanolm/data.py: конвейер претрейн-корпуса из функций normalize_unicode, extract_text,
detect_language, quality_filters, mask_pii, exact_dedup, minhash_signature,
lsh_buckets, fuzzy_dedup, decontaminate, run_pipeline с отчётом по этапам. Задание в exercises/data.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_data.py -v. python scripts/data_pipeline.py даёт
отчёт конвейера и обучение одной и той же TINY-модели на сыром и на чистом корпусе.
Это отдельная неделя 15b: лаборатория данных: теория (NFKC, MinHash, выбор b и r,
деконтаминация, PII и лицензии), задания и вопросы интервью. Если идёшь строго
по 24 неделям, сделай на неделе 15 её сжатый вариант на 8 часов (описан там же).
Математика (трек D): D21: MinHash и LSH для дедупликации; D22: смещение, дисперсия и shrinkage.
Интервью-вопрос недели: «Как работает LoRA и когда её не хватит?» Структура на 3 минуты:
(1) первым идёт формула: W заморожена, обучается поправка ΔW = B·A ранга r; (2) цифра: W 4096×4096 это
16.8 млн чисел, адаптер при r = 8 всего 65 536, 0.4%; градиенты и состояние Adam нужны только адаптерам,
поэтому из 16 байт на параметр (неделя 9) у замороженного веса остаются 2, у QLoRA полбайта;
(3) инициализация: B = 0, на старте выход не меняется; после обучения B·A вливается в W,
и инференс ничего не стоит сверху; (4) главный вывод: ранг это потолок, а не ручка «побольше, значит лучше»:
если нужная правка полноранговая, низкий ранг её не закроет никогда; (5) жди «а если обнулить и A, и B»:
градиент по каждой пропорционален другой, оба нулевые, обучение не стартует.
Результаты недели
- Могу реализовать
LoRALinear,apply_lora,merge_loraи пройти все тесты модуля. - Могу посчитать число обучаемых параметров и экономию памяти LoRA для заданного ранга и набора слоёв.
- Могу объяснить, что именно выучит модель, если не маскировать лосс на промпте.
- Могу описать конвейер near-duplicate дедупликации через MinHash и LSH.
Самопроверка
- Почему
Bинициализируют нулями, аAслучайно, и что будет, если наоборот? - Почему ранг это потолок качества LoRA, а не ручка «побольше, значит лучше»?
- Что такое деконтаминация и почему без неё бенчмарк ничего не доказывает?