Неделя 14. Scaling laws, точность, параллелизм
Учиться в приложении: тьютор, задачи с кодом →
Ядро: Chinchilla, коллективы, DDP, ZeRO и FSDP, tensor и pipeline parallelism, bf16 против fp16, квантование absmax · Глубина: FP8 и точность накопления, параллелизм на инференсе, задачи про MoE · ≈ 14 ч ядро / 25 ч всё
Неделя 9 говорит, сколько стоит модель; эта о том, как распорядиться бюджетом и железом. Scaling laws решают, какую модель и на скольких токенах учить; форматы чисел решают, во что её упаковать; параллелизм решает, как разложить её по GPU, когда 16 байт на параметр не помещаются в одну. Без этого не ответить ни на «сколько стоит обучение», ни на «5D parallelism».
На пальцах. Бюджет обучения равен C ≈ 6·N·D FLOPs (неделя 9), где N это параметры, D токены.
Chinchilla отвечает, как этот бюджет делить: около 20 токенов на параметр.
Модели на 1 млрд параметров нужно 20 млрд токенов: 6 · 10⁹ · 2·10¹⁰ = 1.2·10²⁰ FLOPs,
на H100 при MFU 40% это около 84 GPU-часов. Вдвое большая модель на том же бюджете увидит
вдвое меньше токенов, и её лосс выйдет хуже, чем у оптимальной.
Llama 3 8B обучали на ~15 трлн токенов: это около 1900 на параметр, почти в 100 раз больше «оптимума».
Обучение дороже, зато маленькую модель дешевле обслуживать каждый день.
- Kaplan vs Chinchilla: compute-optimal (лучший лосс при фиксированном бюджете FLOPs), соотношение токенов к параметрам ~20:1, и почему на практике переобучают дольше (стоимость инференса)
- Прогнозирование лосса, эмерджентность (скачкообразное появление способности с ростом масштаба) и критика самого понятия: скачок часто создаёт метрика «всё или ничего», а не модель
На пальцах. В fp16 число 70 000 уже не помещается, получается inf, а градиент 10⁻⁸ превращается в 0.
bf16 хранит оба: диапазон у него как у fp32, до ~3·10³⁸. Зато значащих бит в bf16 всего 8,
и 257 округляется до 256: соседние представимые числа там идут через 2. fp16 хранит 257 точно.
Биты порядка дают диапазон, биты мантиссы точность, и в 16 битах приходится выбирать.
Поэтому fp16 требует loss scaling (домножения лосса, чтобы мелкие градиенты не обнулились), а bf16 обычно нет.
- Точность: fp32, tf32, bf16, fp16, fp8. Диапазон vs мантисса (значащие биты числа)
- Квантование (хранение весов, активаций или KV-кэша в меньшем числе бит): int8, int4, GPTQ, AWQ, QAT (обучение с учётом квантования). Это опорное место курса: недели 11, 13 и 15 ссылаются сюда
На пальцах. Квантуем в int8 вектор (0.3, −0.5, 0.12, 1.5) по absmax (масштабу по максимуму модуля):
шаг сетки scale = 1.5 / 127 ≈ 0.0118, q = round(x / scale) = (25, −42, 10, 127), обратно q·scale = (0.295, −0.496, 0.118, 1.5).
Теперь замени 1.5 на выброс 30. Шаг вырос до 0.236, и выходит (1, −2, 1, 127): числа 0.3 и 0.12 слились,
всем числам до 0.5 по модулю досталось 5 уровней (от −2 до 2) из 255. Разрежь вектор на блоки по 2 со своим шагом,
и первая пара получит (76, −127): выброс испортил только свой блок.
- Absmax:
scale = max|x| / (2^(b−1) − 1)(шаг сетки),q = round(x / scale),x ≈ q·scale. Масштаб бывает на тензор, на канал и на блок. Чем мельче блок, тем меньше вредит выброс, но тем больше масштабов хранить. Форматы MX (microscaling) дают общий масштаб каждым 32 числам; DeepSeek-V3 при FP8-обучении брал свой масштаб на каждые 128 чисел активаций и на блок 128×128 весов. Масштаб считают по текущему блоку (online), а не по максимумам прошлых шагов (delayed scaling): так выброс не застаёт врасплох - FP8 двух видов: E4M3 (4 бита порядка, 3 мантиссы, максимум 448) точнее, E5M2 (5 и 2, максимум 57 344) шире. Классическая схема: E4M3 для весов и активаций, E5M2 для градиентов. С мелкоблочным масштабом хватает E4M3 везде. В FP8 делают матмулы, а эмбеддинги, выходная голова, нормы, мастер-веса и состояния оптимизатора остаются в bf16 или fp32
- Точность накопления. На пальцах. В E4M3 между 64 и 128 соседние числа идут через 8, поэтому
64 + 3 = 64. Сложи 100 троек, округляя сумму в E4M3 после каждого шага: за 18 шагов дойдёшь до 64 и застрянешь, выйдет 64 вместо 300. Поэтому произведения FP8 суммируют в более широком аккумуляторе и регулярно переносят частичные суммы в fp32: с переносом каждые 8 слагаемых те же 100 троек дают ровно 300. В DeepSeek-V3 заметили, что аккумулятор тензорных ядер при FP8 держит лишь около 14 бит, и переносили суммы в fp32 через фиксированные интервалы
Код → nanolm/quant.py: quantize_symmetric (на тензор и на канал), quantize_affine с нулевой точкой
(кодом, в который точно попадает 0.0), quantize_blockwise, QuantizedLinear (int8 и масштаб на выходной канал),
quantize_model и model_size_bytes. Задание в exercises/quant.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_quant.py -v.
В коде scale тот же шаг сетки, что и в примере выше (x ≈ q·scale), так же его понимает PyTorch.
Проверь руками: выброс в одной строке портит квантование по тензору сильнее, чем по каналам и по блокам,
а NanoLM после quantize_model почти не меняет лосс, хотя веса слоёв стали почти в 4 раза легче.
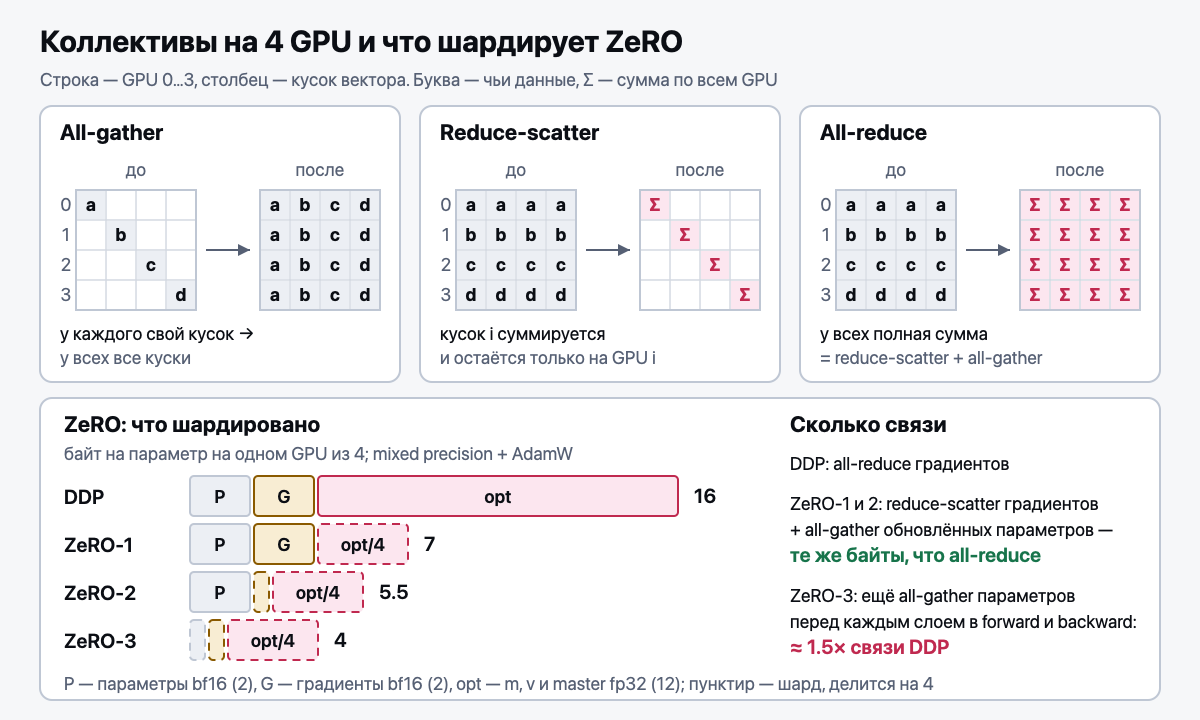
На пальцах. 4 GPU, у каждого свой градиент из 4 чисел: (1, 2, 3, 4), (5, 6, 7, 8), (9, 10, 11, 12), (13, 14, 15, 16).
Нужно, чтобы у всех оказалась сумма (28, 32, 36, 40).
Reduce-scatter: GPU 0 собирает только первые элементы и получает 1 + 5 + 9 + 13 = 28, GPU 1 собирает вторые и получает 32, и так далее.
Каждый отправил три своих числа и держит одну сумму.
All-gather: каждый рассылает свою сумму трём остальным: это ещё три числа.
Итого 6 отправленных чисел на GPU при массиве из 4. В общем виде 2·(p−1)/p размера массива при p GPU:
при 8 GPU это 1.75×, при 1000 почти 2×, то есть цена от числа GPU почти не растёт.
- Коллективные операции (обмены, в которых участвуют все GPU группы): broadcast, reduce, all-reduce, all-gather, reduce-scatter (all-reduce = reduce-scatter + all-gather)
На пальцах. Четыре GPU это четыре человека, и у каждого одинаковая тетрадь: веса, градиенты, записи оптимизатора.
В DDP (обычный data parallel) у каждого полная копия. Для 7B при mixed precision это 16 байт на параметр (неделя 9),
112 ГБ на каждом GPU без учёта активаций, в 80 ГБ не влезает. ZeRO делит тетрадь на четверых.
ZeRO-1 делит только записи оптимизатора (12 байт из 16): 2 + 2 + 12/4 = 7 байт на параметр, 49 ГБ.
ZeRO-2 делит ещё и градиенты: 2 + 2/4 + 3 = 5.5 байта, 38.5 ГБ. ZeRO-3 делит и сами веса: 16 / 4 = 4 байта, 28 ГБ.
Веса слоя при этом собираются all-gather'ом прямо перед использованием и сразу выбрасываются.
- Виды параллелизма:
- Data parallelism (каждый GPU держит всю модель и считает свою часть батча), ZeRO этапы 1/2/3, FSDP (реализация ZeRO-3 в PyTorch)
- Tensor parallelism (одна матрица слоя разрезана между GPU; расщепление по столбцам/строкам, где нужен all-reduce)
- Pipeline parallelism (слои разложены по GPU, микробатчи идут конвейером), пузырь конвейера
(доля времени, когда часть GPU ждёт: при 4 стадиях и 8 микробатчах
3/11 ≈ 27%), 1F1B (расписание, где forward и backward микробатчей чередуются) - Sequence / context parallelism (делится длина последовательности), expert parallelism (эксперты MoE на разных GPU)
- Когда tensor parallelism упирается в связь. Разрежем матмул
(B×D)·(D×F)по внутренней размерностиDна 2 GPU. Каждый считаетB·D·F / Pсекунд и потом отдаёт в all-reduceB·F·2байта за2·B·F / W_netсекунд.BиFсокращаются: счёт дольше связи приD > 2·P / W_net. H100 с NVLink (около 450 ГБ/с в одну сторону) даётD > 4 400: у Llama-3-8B (D = 4096) связь уже наравне со счётом, а межузловая сеть в разы медленнее NVLink. Поэтому TP держат внутри узла. Для инференса то же рассуждение продолжено ниже, в «Параллелизм на инференсе» - Отсюда «5D parallelism», вопрос, который задают на интервью дословно
- Выбор стратегии: что упирается в память, что в связь
Параллелизм на инференсе. Всё выше было про обучение. При обслуживании модели цель другая: не уместить состояние оптимизатора, а уложиться в TTFT и TPOT (неделя 11). Числа шага decode взяты из шага 4 недели 11.
На пальцах. Промпт на 2 000 токенов стоит около 3.1·10¹³ FLOPs: при MFU 50% на H100 это 63 мс.
Вставь такой prefill между шагами decode батча из 32 (шаг 7.6 мс при контексте около 2 250), и все 32 пользователя
простоят больше 8 шагов: токены у них пойдут рывками. Отдай prefill отдельной машине, и рывков нет,
зато кэш промпта (262 МБ) придётся переслать по сети.
- Шардирование при инференсе. Prefill похож на обучение без backward: работает tensor parallelism, а на очень длинных промптах ещё и деление по последовательности. В decode выбор уже. FSDP вреден: собирать веса по NVLink (около 450 ГБ/с в одну сторону) в 7 раз медленнее, чем читать их из своей HBM. Data parallel шаг не ускоряет: это просто независимые реплики. Делить последовательность нечего, новый токен один. Остаётся tensor parallelism: каждый GPU читает свою долю весов и свою долю кэша (кэш режут по KV-головам), а по сети идут только активации
- Цена этого на примере: Llama-3-8B,
B = 32, 8k. На 2 GPU шаг 15.1 → 7.5 мс. Но на шаг приходится 64 all-reduce (два на слой) поB·D·2 = 256КиБ. По полосе это доли микросекунды, а задержка запуска каждого порядка 10 мкс, около 0.6 мс на шаг. На 8 GPU шаг 1.9 мс, и связь добавляет к нему ещё треть. Шардируют ради латентности или когда модель не влезает в один GPU, а ради пропускной способности дешевле независимые реплики. Если GPU больше, чем KV-голов, кэш дополнительно делят по батчу - Как совмещать prefill и decode. (1) Общий батч: просто, но каждый prefill останавливает decode, как в примере.
(2) Chunked prefill (Sarathi-Serve): промпт режут на куски и подмешивают в шаги decode. Шаг при
B = 32недогружен по арифметике: 32 токена decode и 256 токенов промпта дают2·N·288/P = 4.4мс счёта, всё ещё меньше 4.79 мс чтения весов, и кусок промпта едет почти бесплатно. (3) Disaggregated serving (раздельные пулы; DistServe, Splitwise): одни GPU делают только prefill, другие только decode, кэш передают по сети. Пулы растят отдельно: prefill отвечает за TTFT, decode за TPOT - Пропорция пулов на примере: промпт 2 000 токенов, ответ 500. Prefill-GPU пропускает
1 / 0.063 ≈ 16запросов/с. Decode-GPU приB = 32делает шаг 7.6 мс и 500 шагов на батч:32 / (500 · 7.6 мс) ≈ 8.4запроса/с. На один prefill-GPU нужно около двух decode-GPU. Чем длиннее ответы, тем больше доля decode
Практика: составить конкретный план обучения 7B на 8×H100 и на 512×H100: какой параллелизм, какой размер батча, оценка времени и стоимости. Защитить выбор вслух.
Задачи на салфетке. Внутри узла 8 H100, NVLink даёт 450 ГБ/с на GPU, межузловая сеть 50 ГБ/с на GPU, MFU 40%.
Коллектив на p участников прогоняет через каждый GPU около (p − 1)/p массива (all-reduce вдвое больше).
- FSDP для 7B в одном узле, 16 384 токенов на GPU за шаг. Сколько времени уходит на связь и сколько на счёт?
- Тот же FSDP растянули на 64 узла (512 GPU). Что стало со связью и как это исправить?
- 70B на 64 H100 (8 узлов). Влезает ли состояние обучения при FSDP только внутри узла? По всем 64 GPU? Какой есть третий вариант?
- MoE: 24 слоя,
D = 2048, эксперт SwiGLU из3·D·Fпараметров приF = 1024, 64 маршрутизируемых и 2 общих эксперта,top-6, внимание4·D²на слой, эмбеддинги не считаем. Сколько параметров всего и сколько активно на токен? Сколько весят веса на GPU при expert parallelism на 8 GPU? - Та же MoE, 8 192 токенов на GPU. Сколько байт уходит в all-to-all на слой в forward и сколько это времени внутри узла и между узлами? Сравни со счётом слоя при MFU 50%.
Ответы. (1) Веса в bf16 весят 14 ГБ. За шаг три коллектива: all-gather весов в forward, ещё один в backward
и reduce-scatter градиентов. Каждый 7/8 · 14 ≈ 12.3 ГБ, 27 мс; всего около 80 мс. Счёт
6 · 7·10⁹ · 16 384 / (989·10¹² · 0.4) ≈ 1.7 с. Связь около 5%, и её прячут за счётом.
(2) Каждый коллектив теперь идёт через межузловую сеть: 14 / 50 ≈ 0.28 с, три коллектива 0.84 с, половина счёта.
Лечит HSDP (гибридное шардирование): состояние шардируют внутри узла, а между узлами держат реплики. Тогда между
узлами идёт только all-reduce своей восьмой части градиентов: 2 · 1.75 / 50 ≈ 0.07 с.
(3) Состояние 16 · 70·10⁹ = 1.12 ТБ. На 8 GPU это 140 ГБ на каждом: не влезает. На 64 GPU 17.5 ГБ, и около 60 ГБ
остаётся на активации. Третий вариант: TP = 8 внутри узла и ZeRO-1 между узлами, 8.75·10⁹ · (2 + 2 + 12/8) ≈ 48 ГБ.
(4) Эксперт 3 · 2048 · 1024 ≈ 6.3 млн, внимание 16.8 млн. Слой (64 + 2) · 6.3 + 16.8 ≈ 432 млн, всего около
10.4 млрд. Активно (6 + 2) · 6.3 + 16.8 ≈ 67 млн на слой, 1.6 млрд всего: считает такая MoE как модель на 1.6 млрд,
а память занимает как модель на 10.4 млрд. При EP = 8 у GPU по 8 маршрутизируемых экспертов каждого слоя плюс копия
общих экспертов и внимания: (8 + 2) · 6.3 + 16.8 ≈ 80 млн на слой, 1.9 млрд параметров, 3.8 ГБ.
(5) Раздать токены: 8 192 · 6 · 2 048 · 2 ≈ 201 МБ, собрать обратно столько же; на другие GPU уходит 7/8, около
350 МБ. Внутри узла 0.35 / 450 ≈ 0.8 мс, между узлами 7 мс. Счёт слоя 2 · 67·10⁶ · 8 192 / (989·10¹² · 0.5) ≈ 2.2 мс.
Внутри узла связь прячется за счётом, между узлами она втрое дольше счёта. Поэтому expert parallelism держат внутри
узла или ограничивают число узлов, куда может уйти один токен.
Математика (трек D): D19: сколько токенов нужно, чтобы оценить лосс; D20: compute-optimal размер модели через множители Лагранжа.
Интервью-вопрос недели: «Как обучить 7B на 8×H100? Какой параллелизм и почему?»
Структура на 3 минуты: (1) первым идёт память, а не FLOPs: 16 байт на параметр → 112 ГБ на каждом GPU
при DDP, в 80 ГБ не влезает ещё до активаций; (2) вывод: шардировать состояние через ZeRO/FSDP; ZeRO-3
на 8 GPU оставляет 16/8 = 2 байта на параметр, 14 ГБ; ZeRO-1 к DDP связи не добавляет:
all-reduce и есть reduce-scatter + all-gather; (3) активации считаются отдельно: у Llama-3-8B при батче 8 × 8192
это 384 GiB (budget.py), их режут checkpointing и микробатчи; (4) связь: all-reduce стоит
2·(p−1)/p массива, при 8 GPU это 1.75×; pipeline только если слои не влезают, с пузырём
3/11 ≈ 27% при 4 стадиях и 8 микробатчах; (5) время: 6N × токены / (8 × 989 TFLOPs × MFU),
токены берём из расчёта ~20 на параметр по Chinchilla или больше ради дешёвого инференса; (6) жди «а на 512×H100?»:
основной рост за счёт data parallel, упор в глобальный батч и межузловую связь.
Источники: Hoffmann et al., Chinchilla (2022); Micikevicius et al., Mixed Precision Training (2018) и FP8 Formats for Deep Learning (2022); Rouhani et al., Microscaling Data Formats (2023); DeepSeek-V3 (2024), FP8-обучение с блочным масштабом и переносом сумм в fp32; Rajbhandari et al., ZeRO (2020); для инференса Agrawal et al., Sarathi-Serve (2024); Zhong et al., DistServe (2024); Patel et al., Splitwise (2024).
Глубже: 05-ГЛУБИНА, разделы «★★ Неделя 14. Параллелизм: считать, а не называть», «Неделя 14. μP и подгонка scaling laws» и «Неделя 14. Precision: практика, а не только теория».
Результаты недели
- Могу составить план параллелизма для 7B на 8×H100 и на 512×H100 и защитить его вслух.
- Могу расписать коллективы для полного слоя трансформера при TP = 8.
- Могу объяснить, почему ZeRO-1 не добавляет коммуникации по сравнению с DDP.
- Могу посчитать compute-optimal размер модели и число токенов для заданного бюджета по Chinchilla.
- Могу проквантовать вектор по absmax руками и объяснить, зачем блочный масштаб и накопление в fp32 при FP8.
- Могу объяснить, почему в decode шардируют только тензорно и когда prefill выносят на отдельные GPU.
Самопроверка
- Из каких двух коллективов состоит all-reduce и почему all-gather вперёд соответствует reduce-scatter назад?
- bf16 против fp16: чем отличаются диапазон и мантисса и когда что выбирать?
- Откуда берётся пузырь конвейера и от чего зависит его доля?
- Почему один выброс портит int8-квантование всего тензора и как это лечит блочный масштаб?
✅ Контрольная точка 3
Rapid-fire, 30 вопросов за 30 минут, вслух, по всей фазе 3.