Неделя 13. GPU и FlashAttention
Учиться в приложении: тьютор, задачи с кодом →
Ядро: SRAM и HBM, arithmetic intensity и roofline, критический батч, FlashAttention · Глубина: Triton, замеры с интервалами в bench.py · ≈ 11 ч ядро / 22 ч всё
До сих пор мы считали FLOPs. Эта неделя о том, почему FLOPs врут: большая часть операций
трансформера упирается не в арифметику, а в чтение и запись памяти. FlashAttention здесь главный пример:
те же FLOPs (с пересчётом даже больше), а быстрее в разы, и память O(S) вместо O(S²).
Без него длинного контекста из недели 20 просто не было бы.
Шаг 1. Модель GPU и roofline
На пальцах. H100 умеет ~989 триллионов операций в секунду, а читать из памяти только 3.35 ТБ/с. Чтобы арифметика не простаивала, на каждый прочитанный байт нужно сделать ~300 операций. Сложение двух векторов в bf16 читает 4 байта, пишет 2 и делает одну операцию: 1 операция на 6 байт. GPU при этом загружен меньше чем на 0.1%: он просто ждёт память. Большой матмул переиспользует каждое прочитанное число сотни раз и упирается уже в арифметику.
- Модель GPU: SM, warp, регистры, SRAM vs HBM, пропускная способность. SM (потоковый мультипроцессор, у H100 их 132) исполняет warp'ы, группы по 32 потока с одной инструкцией. Регистры и SRAM (shared memory, сотни КБ на SM) быстрые и крошечные; HBM (основная память, 80 ГБ) большая и медленнее
- Arithmetic intensity, roofline-модель. Почему attention memory-bound, а матмулы compute-bound.
Время ≥
max(FLOPs / P, байты / W), интенсивностьI = FLOPs / байты, порогP/W ≈ 295FLOP/байт. Ниже порога операция memory-bound. В наивном внимании на каждый элемент матрицыS×Sприходится несколько операций (маска, exp, деление), а уQKᵀвнутренняя размерность всегоH = 64…128 - Критический размер батча. Проход по слоям с
Nвесами читаетN·bбайт (bбайт на вес) и делает2·N·BFLOPs, гдеBчисло токенов в этом проходе. Чтение и счёт занимают равное время приB* = P·b / (2W). Для bf16 (b = 2) это простоP/W: у H100 около 295, у A100 (312 TFLOP/с, 2.04 ТБ/с) около 153. Ниже порога проход стоит одно чтение весов, и добавочные токены почти бесплатны; выше каждый токен добавляет время. Порог считают в токенах, а не в последовательностях: prefill одного промпта на 2 000 токенов уже compute-bound, decode 64 пользователей даёт 64 токена, а проверка черновика в speculative decoding даётB·(γ + 1). Квантование (хранение весов или кэша в 8 или 4 битах вместо 16; опорный разбор в неделе 14) сдвигает порог: int8-веса при bf16-арифметике вдвое снижают байты, иB* ≈ 148; если и арифметика int8 (у H100 около 1979 TOPS), порог возвращается к ≈ 295. На практике до порога часто не дойти: у Llama-3-8B на H100 при контексте 8k в память влезает 59 последовательностей, место под кэш кончается раньше FLOPs (неделя 11) - Внимание в decode батч не спасает: у каждого запроса свой кэш, и его интенсивность при любом
BоколоN/KFLOP/байт (у Llama-3-8B 4, при MHA 1). Отсюда второй смысл GQA: кэш не только меньше, но и читается с большей пользой - Fusion ядер: зачем вообще нужны кастомные ядра. Цепочка поэлементных операций, слитая в одно ядро,
читает и пишет тензор один раз вместо
kраз. Вscripts/profile_train.py(неделя 22) поэлементные операции занимают 39% времени
Шаг 2. FlashAttention
На пальцах. При S = 4096 и 32 головах матрица оценок в fp16 занимает 1 ГиБ на слой на один пример.
Наивное внимание пишет её в HBM, читает для softmax, пишет результат и читает снова для умножения на V.
FlashAttention берёт блок запросов и блок ключей, считает их кусок оценок прямо в SRAM
и сразу умножает на блок V. Бегущие максимум и сумма (online softmax из недели 4) склеивают блоки
правильно. В HBM уходит только выход, матрица целиком не существует нигде.
- FlashAttention: tiling по блокам + online softmax (неделя 4!) → никогда не материализуем матрицу
S×S. Backward с пересчётом. FA2, FA3. Для каждого блокаQдержимm,d,oи идём по блокамK,V; при новом максимуме старыеdиoумножаются наe^{m_old − m_new}. Обращения к HBM:Θ(S²H²/M)противΘ(SH + S²)у наивного, гдеMэто размер SRAM
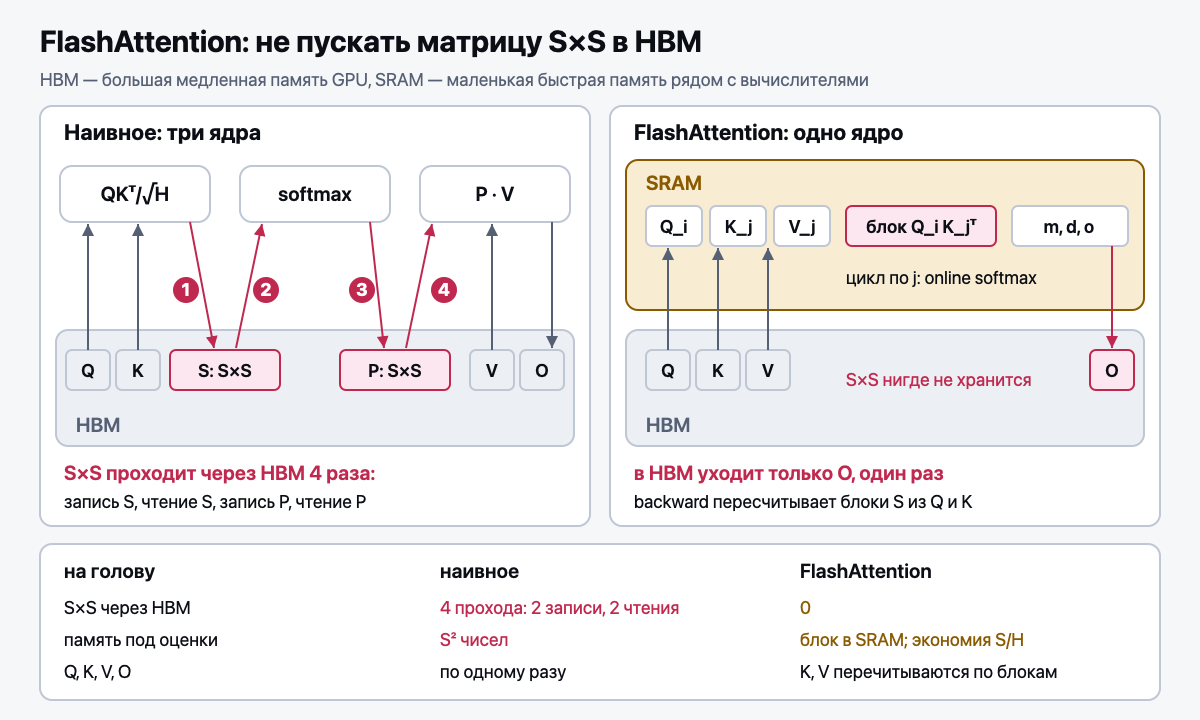
- Backward сохраняет только выход и logsumexp каждой строки, а блоки оценок и вероятностей
пересчитывает из
Q,K,V. Лишние FLOPs дешевле: арифметика простаивает, а память нет - Результат точный, а не приближённый: математика та же, меняется только порядок суммирования. С каузальной маской блоки целиком выше диагонали пропускаются: это ещё ~2× экономии
- FA2 параллелит и по длине последовательности и сокращает не-матмульные операции. FA3 использует асинхронность Hopper (TMA, специализация warp'ов) и FP8
- Введение в Triton: что такое программная модель, как выглядит простое ядро. Одна программа
обрабатывает один блок:
tl.program_id, смещения черезtl.arange,tl.load/tl.storeс маской на хвосте,tl.dotдля блочного матмула. Потоки и shared memory раскладывает компилятор
Типичные ошибки
- Не домножить старые
dиoпри новом максимуме:test_online_softmax_matches_direct_computation,test_online_softmax_block_size_does_not_matter - Начать с
m = 0или не обработатьm = −inf: на полностью замаскированном блокеe^{−inf − (−inf)}даёт NaN. Эталон проверяетtorch.isfinite(m); большие логиты проверяетtest_online_softmax_handles_large_logits - Мерить время GPU без синхронизации: ядра асинхронны, замеряется только постановка в очередь.
В бенчмарке для этого
sync()и прогревWARMUP(первый вызов ещё и компилирует/выделяет память)
Код → scripts/attention_bench.py: наивное внимание (naive_attention из modules.py) против
F.scaled_dot_product_attention по времени и памяти при S = 256…4096,
плюс таблица квадратичного роста матрицы оценок до контекста 131k. Функции timed (медиана
после прогрева), sync, score_matrix_bytes. FlashAttention в миниатюре это online_softmax_weighted_sum
в stability.py, тесты в tests/test_stability.py.
Смотреть надо не на ускорение (~4×), а на два других числа: экономия памяти
равна ровно S/H (отношение матрицы S×S к выходу S×H; скрипт его считает, а не измеряет),
а расхождение между реализациями ~5e-7, то есть FlashAttention точный, а не приближённый.
SDPA сам выбирает ядро под устройство (на CUDA это FlashAttention, на CPU своя flash-реализация,
её видно в профиле недели 22): числа зависят от железа, картина нет. По желанию напиши своё Triton-ядро.
Код → nanolm/bench.py: time_fn (прогрев не входит в замеры, sync для CUDA, подменяемые часы),
BenchResult (среднее, std, p50, p95, полуширина 95%-интервала по t-распределению Стьюдента; как сравнить два варианта статтестом, в неделе 18),
t_critical_95, pareto_frontier (варианты, которые нельзя улучшить по одной оси, не ухудшив другую).
Задание в exercises/bench.py, проверка: NANOLM_IMPL=exercises pytest tests/test_bench.py -v.
Главное здесь дисциплина, а не формулы: одно число без прогрева и разброса не аргумент.
При 5 замерах честный интервал с t = 2.776 в 1.4 раза шире, чем с привычным 1.96.
Математика (трек D): D17: арифметическая интенсивность матмула и decode на roofline;
D18: порядок умножений и линейное внимание: Q(KᵀV) вместо (QKᵀ)V.
Интервью-вопрос недели: «Почему FlashAttention быстрее, если FLOPs у него не меньше?»
Структура на 3 минуты: roofline и порог интенсивности → наивное внимание гоняет S×S через HBM →
tiling + online softmax убирают этот трафик → backward пересчитывает вместо чтения → результат точный →
главное следствие не скорость, а память O(S): без этого контекст 128k не помещается.
Источники: Williams et al., Roofline (2009); Dao et al., FlashAttention (2022); Dao, FlashAttention-2 (2023); Shah et al., FlashAttention-3 (2024); Tillet et al., Triton (2019); Milakov & Gimelshein, Online softmax (2018).
Результаты недели
- Могу посчитать arithmetic intensity матмула и поэлементной операции и разместить их на roofline.
- Могу вывести критический размер батча
P·b / (2W)и сказать, как его сдвигает квантование. - Могу объяснить FlashAttention через tiling и online softmax без материализации матрицы
S×S. - Могу запустить
attention_bench.pyи объяснить, откуда экономия памяти ровноS/H. - Могу прочитать простое Triton-ядро и сказать, что делает каждая программа.
Самопроверка
- Почему внимание memory-bound, а большой матмул compute-bound?
- Что пересчитывает backward FlashAttention и почему пересчёт дешевле хранения?
- Какой ресурс экономит слияние ядер и почему это важнее FLOPs для поэлементных операций?
- Чему равен критический батч у H100 в bf16 и с int8-весами и почему его считают в токенах?