Неделя 12. Стратегии сэмплирования
Учиться в приложении: тьютор, задачи с кодом →
Ядро: температура, top-k, top-p, min-p, beam search, штрафы за повтор · Глубина: constrained decoding и грамматики, typical sampling · ≈ 10 ч ядро / 19 ч всё
Модель выдаёт распределение, а какой текст получится, решает правило выбора. Одна и та же модель с greedy и с top-p это два разных продукта: первая повторяется, вторая иногда несёт чушь из хвоста. Вся неделя о том, как отрезать хвост распределения, не убив разнообразие.
Шаг 1. Форма распределения
На пальцах. Логиты (сырые оценки модели до softmax) [2, 1, 0]. При температуре 1 вероятности
[0.67, 0.24, 0.09]. Температура 0.5 удваивает логиты: [0.87, 0.12, 0.02], лидер забирает почти всё.
Температура 2 делит их пополам: [0.51, 0.31, 0.19], выбор почти случайный. Порядок токенов
не меняется никогда, меняется только то, насколько резко лидер отрывается от остальных.
- Greedy, температура, top-k, top-p (nucleus), min-p, typical sampling. Температура:
softmax(l/T); энтропия растёт сT: приT → 0получаем argmax и энтропию 0, приT → ∞равномерное распределение иlog V. Typical sampling оставляет токены, чья «неожиданность»−log pблизка к энтропии распределения
На пальцах. 1000 токенов: 5 хороших по 0.1 (вместе 0.5) и 995 мусорных, делящих остальные 0.5 (по 0.0005). top-p = 0.9 обязан набрать массу 0.9: пять хороших дают 0.5, остальные 0.4 он добирает примерно 800 мусорными токенами. min-p = 0.1 ставит порог 0.1 × 0.1 = 0.01 от лидера и оставляет ровно пять хороших. На пиковом распределении оба ведут себя одинаково, разница только на плоском.
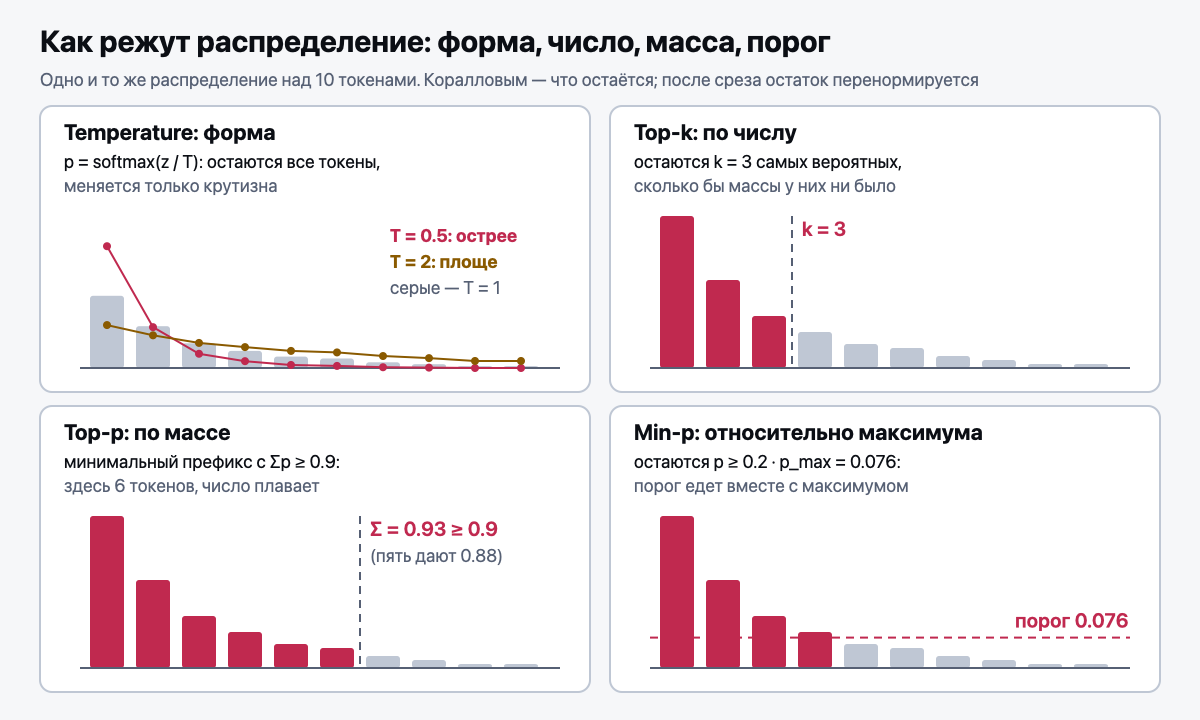
- top-k режет по числу токенов и не знает об уверенности модели; top-p режет по накопленной массе;
min-p по порогу
p_i ≥ min_p · p_max, без сортировки. Порядок важен: сначала температура, потом фильтры, потому что от температуры зависят и масса top-p, и порог min-p. Вsample_from_logits: температура → top-k → min-p → top-p → softmax → выбор
Шаг 2. Поиск и штрафы
- Beam search: почему хорош для перевода и плох для открытой генерации. Он держит
bлучших префиксов по сумме log-вероятностей, то есть ищет самый вероятный текст целиком. В переводе ответ почти определён входом, и мода распределения это хороший ответ. В открытой генерации самый вероятный текст скучен и зацикливается: повтор фразы делает её ещё вероятнее. Нужна нормировка по длине - Repetition / presence / frequency penalty. Repetition мультипликативный: положительный логит делят на штраф, отрицательный умножают. Presence вычитает константу, если токен уже был. Frequency вычитает константу × число появлений. Первые два не различают один повтор и десять, третий различает
Шаг 3. Ограниченная генерация
На пальцах. Нужен JSON. На первом шаге логиты всех токенов, которые не могут начать JSON,
заменяют на −inf. Модель физически не может выбрать ничего другого. Дальше автомат грамматики
помнит, где мы находимся: внутри строки, после ключа, после запятой. На каждом шаге он разрешает
только допустимые продолжения.
- Constrained decoding: JSON-схемы, грамматики, logit-процессоры (функции, правящие логиты перед выбором). Сложность в несовпадении токенов с символами грамматики: один токен может закрывать строку и открывать следующий ключ. Поэтому таблицу «состояние → разрешённые токены» строят заранее. Синтаксис гарантирован, содержание нет, и пошаговое маскирование искажает распределение
- Связь с калибровкой и энтропией распределения: та же температура калибрует уверенность классификатора (temperature scaling), а энтропия шага даёт дешёвый сигнал неуверенности модели
Типичные ошибки
- В top-p выкинуть и тот токен, на котором масса перешла порог: при пиковом распределении выход пуст.
Ловит
test_top_p_always_keeps_at_least_one; неадаптивный срез ловитtest_top_p_adapts_to_confidence - Забыть вернуть исходный порядок после сортировки в top-p. Тесты
test_sampling.pyподают уже отсортированные логиты и этого почти не ловят, проверь сам на перемешанных - Делить отрицательный логит на штраф: он вырастет, ловит
test_repetition_penalty_lowers_seen_tokens. Делить наT = 0: ловитtest_temperature_zero_is_greedy. Оставить большеk: ловитtest_top_k_keeps_exactly_k
Код → nanolm/sampling.py: все стратегии с нуля, единый интерфейс sample_from_logits(logits, **kwargs):
apply_temperature, top_k_filter, top_p_filter, min_p_filter, apply_repetition_penalty.
Задание в exercises/sampling.py: NANOLM_IMPL=exercises pytest tests/test_sampling.py -v.
Beam search в nanolm нет, напиши его поверх NanoLM и сравни с сэмплированием на одном промпте.
Математика (трек D): D15: Gumbel-max, сэмплирование из softmax как argmax зашумлённых логитов;
D16: максимум и минимум из n величин, хвостовая формула и отсутствие памяти.
Интервью-вопрос недели: «Модель в проде зацикливается и повторяет абзац. Что крутить?»
Структура на 3 минуты: проверить режим (greedy, низкая T, beam) → ловушка правдоподобия →
температура и min-p/top-p → frequency penalty, а не presence → измерить (доля повторов n-грамм,
distinct-n) → проверить, что точность фактов не упала → если повторы есть и в данных, чинить данные.
Источники: Holtzman et al., The Curious Case of Neural Text Degeneration (2019); Meister et al., Typical Decoding (2022); Nguyen et al., min-p (2024); Willard & Louf, Outlines (2023).
Глубже: 05-ГЛУБИНА, раздел «Что ещё добавить по мелочи», строка «Неделя 12».
Результаты недели
- Могу реализовать greedy, температуру, top-k, top-p и min-p за единым интерфейсом
sample_from_logits(logits, **kwargs). - Могу на двух распределениях, плоском и пиковом, показать, чем top-p отличается от min-p.
- Могу объяснить, почему beam search склонен к повторам в открытой генерации.
- Могу объяснить, как маскирование логитов гарантирует валидный JSON.
Самопроверка
- Что происходит с энтропией распределения при
T → 0иT → ∞? - Чем frequency penalty отличается от presence penalty?
- Почему latency и throughput конфликтуют при выборе размера батча?