Неделя 11. Инференс
Учиться в приложении: тьютор, задачи с кодом →
Ядро: prefill и decode, KV-кэш, continuous batching и PagedAttention, speculative decoding, цена шага decode · Глубина: MLA, гибрид окон и MTP (05-ГЛУБИНА), трек D · ≈ 13 ч ядро / 24 ч всё
Обучают модель один раз, а обслуживают миллионы запросов, поэтому большая часть денег уходит сюда. Почти всё на этой неделе следует из одного факта: чтобы выдать один токен, модель читает из памяти все свои веса и весь кэш. Кто понял этот факт, тот выводит батчинг, GQA и speculative decoding сам.
Шаг 1. Prefill и decode
На пальцах. Llama-3-8B в bf16 весит 16 ГБ. H100 читает память со скоростью 3.35 ТБ/с, значит один проход по весам занимает не меньше ~4.8 мс. Для одного пользователя это потолок около 200 токенов в секунду, как бы быстро GPU ни умножал. Но если за тот же проход обслужить 64 пользователей, веса читаются один раз, а токенов выходит 64. Арифметики стало в 64 раза больше, время почти то же.
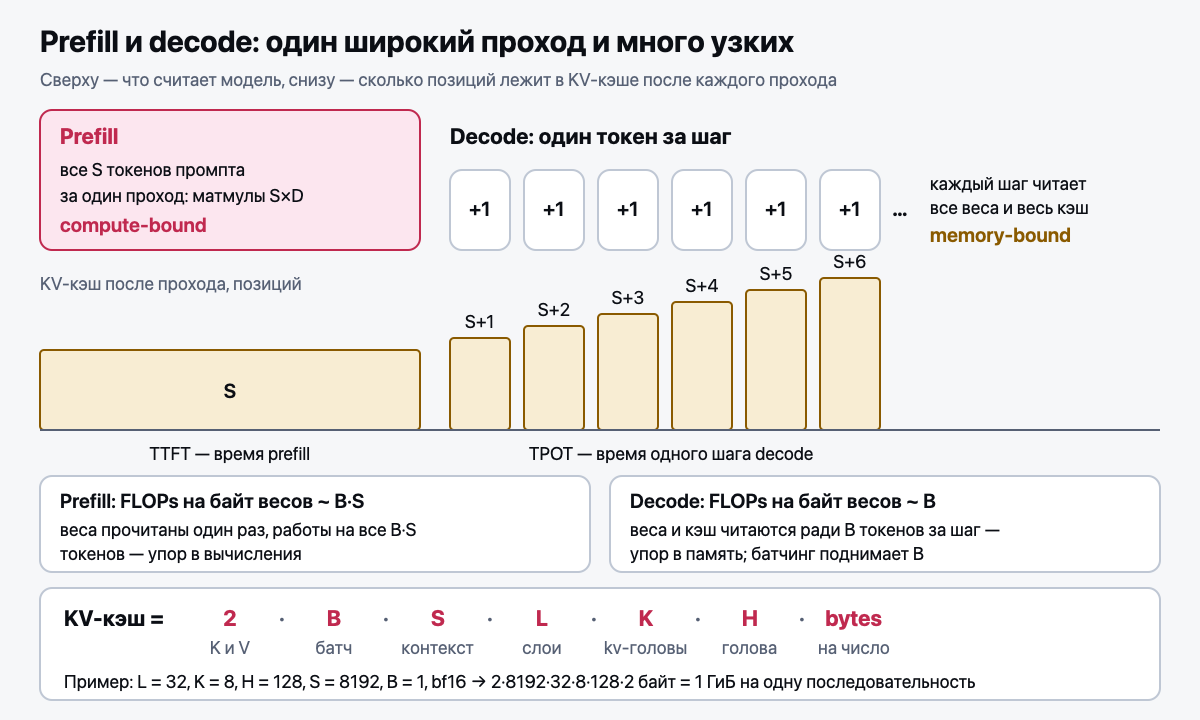
- Prefill vs decode. Prefill упирается в вычисления (compute-bound), decode в память (memory-bound). Из этого следует почти всё остальное.
Prefill обрабатывает весь промпт одним проходом: на каждое чтение веса приходятся тысячи токенов.
Decode выдаёт по одному токену на последовательность: на чтение веса приходится
Bтокенов. Интенсивность (FLOPs на байт) растёт с батчем: подробно в неделе 13 и в задаче D17
Шаг 2. KV-кэш
На пальцах. Без кэша на каждом шаге пришлось бы заново считать ключи и значения для всего
префикса. Но K и V старого токена не меняются, когда приходят новые: их можно посчитать один раз
и хранить. Новый токен считает только свои q, k, v и смотрит на сохранённые. Платить приходится памятью:
у Llama-3-8B это 128 КиБ на каждый токен контекста, 1 GiB на последовательность в 8k токенов.
- KV-кэш: зачем, размер, рост по контексту:
2 · B · S · L · K · H · bytes(вывод в неделе 9), растёт линейно поSи поB. На H100 80 ГБ после 15 GiB весов Llama-3-8B остаётся место примерно под 60 последовательностей по 8k. Батч ограничивает кэш, а не вычисления
- Уменьшение KV-кэша: GQA/MQA, MLA (DeepSeek), sliding window, квантование кэша (хранение K и V в 8 или 4 битах
вместо 16; как квантуют и чем платят, подробно в неделе 14), выгрузка. GQA сокращает кэш в
N/Kраз, окно ограничивает его своим размером, 8-битное квантование сокращает вдвое
Глубина (по желанию). MLA (multi-head latent attention, внимание через сжатый латент; DeepSeek-V2) хранит на токен и слой короткий латент вместо K и V: 576 чисел против 2048 у GQA. Гибрид локального и глобального внимания растит кэш только в глобальных слоях. Разбор в 05-ГЛУБИНА, раздел «Неделя 11. Сжатие кэша и черновики: MLA, гибрид окон, MTP».
- Батчинг: static → dynamic → continuous batching; PagedAttention (vLLM). Static ждёт самого длинного ответа в батче. Continuous планирует по шагам: закончившийся запрос уходит, новый встаёт на его место. PagedAttention хранит кэш блоками с таблицей блоков, как страницы виртуальной памяти: без резерва под максимальную длину, без фрагментации, с общим префиксом для многих запросов
- Prefix caching (кэш общих префиксов): если начало промпта уже встречалось, его K и V не считают заново. Префиксы хранят деревом по токенам, холодные ветки вытесняют по LRU (сначала давно не нужные), часть уходит в память CPU. Роутер должен слать запросы с общим префиксом на ту же реплику, иначе кэш не найдётся. Пример: 20 диалогов с общим системным промптом на 1 000 токенов. Без кэша prefill 20 000 токенов и 2.6 ГБ кэша, с кэшем 1 000 токенов и 131 МБ
Шаг 3. Speculative decoding
На пальцах. Целевая модель p даёт словам A и B вероятности 0.6 и 0.4, черновик q даёт 0.9 и 0.1.
Черновик предлагает A в 90% случаев; принимаем с вероятностью 0.6/0.9 = 2/3, итого A выходит в 60%.
B черновик предлагает в 10% случаев, и p(B) > q(B), поэтому принимаем всегда. Отказов 0.9 · 1/3 = 30%,
и при отказе берём из остатка max(0, p − q) = (0, 0.3), то есть только B.
B выходит в 10% + 30% = 40%. Ровно p, без приближений.
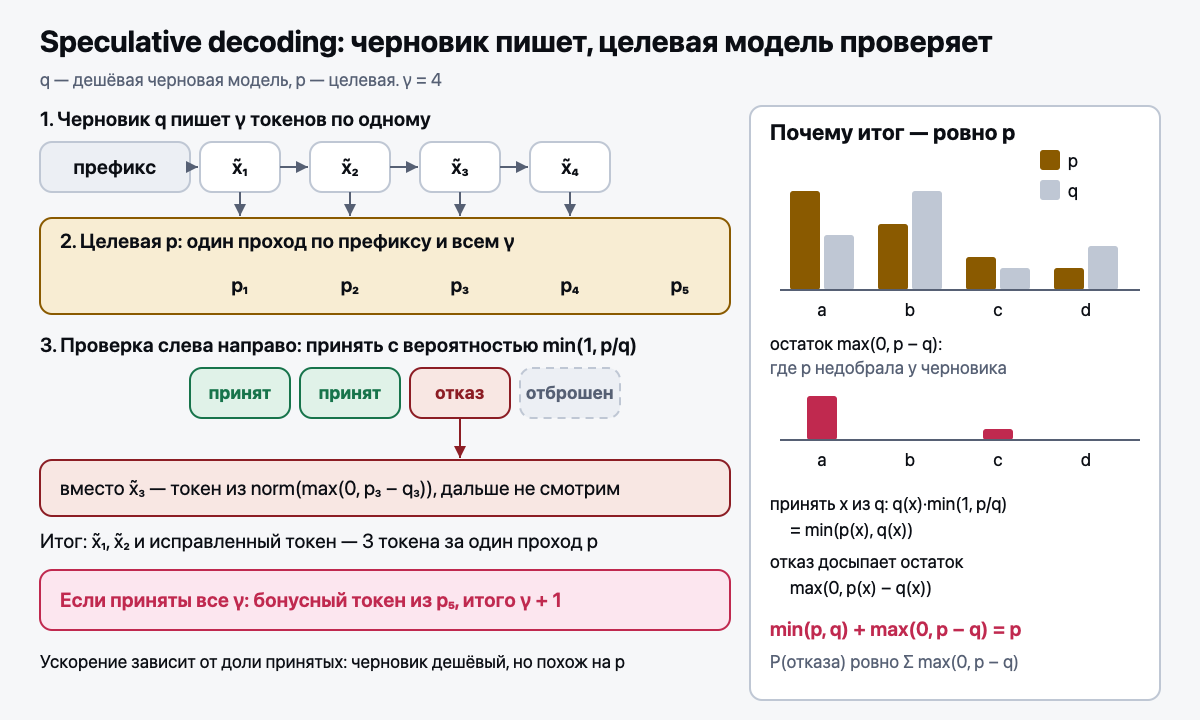
- Speculative decoding: черновая модель + верификация; почему распределение остаётся точным
(разобрать шаг отклонения-принятия). Принят из черновика:
q(x)·min(1, p(x)/q(x)) = min(p, q). Отказ: избыткиqнадpиpнадqв сумме равны (обе суммируются к 1), нормировка сокращается, остаётсяmax(0, p − q). Итогmin(p, q) + max(0, p − q) = p. Варианты: Medusa, EAGLE, n-gram, модули MTP (multi-token prediction, предсказание нескольких токенов) из DeepSeek-V3: глубина, тот же раздел 05-ГЛУБИНА - Почему проверка почти бесплатна:
γ + 1токенов одним проходом читают веса один раз, как обычный шаг. ПокаB·(γ + 1)токенов ниже критического батча (у H100 около 295; подробно в неделе 13), лишняя арифметика прячется за чтением. При большом батче запаса нет, и выигрыш пропадает
- Метрики: TTFT, TPOT, throughput vs latency. TTFT (time to first token) это очередь плюс prefill, TPOT (time per output token) это шаг decode. Больший батч поднимает throughput и ухудшает TPOT каждого
Шаг 4. Сколько стоят шаг decode и миллион токенов
На пальцах. Llama-3-8B на H100, контекст 8k. Каждый шаг читает 16.06 ГБ весов: 4.79 мс при 3.35 ТБ/с.
Кэш одной последовательности (1.07 ГБ) читается ещё 0.32 мс. Один пользователь: шаг 5.1 мс, 196 токенов в секунду.
32 пользователя: веса те же 4.79 мс, кэш 32 · 0.32 = 10.3 мс, шаг 15.1 мс, но за шаг выходит 32 токена: 2 126 ток/с.
Батч вырос в 32 раза, шаг в 3 раза, выдача в 11 раз.
- Время шага decode, оценка снизу:
t ≈ B·KV/W + max(байты весов / W, 2·N·B / P), гдеWполоса памяти,Pпик FLOP/с,KVбайты кэша одной последовательности,Nчисло параметров. Почему чтение и счёт сравнивают через максимум, объясняет модель roofline: подробно в неделе 13. Кэш читается всегда, делить его не с кем. Веса упираются в память, покаBниже критического батча (у H100 около 295 токенов). В примере2·N·B/PприB = 32всего 0.49 мс против 4.79 мс чтения весов. Реальный шаг медленнее оценки обычно в 1.2–2 раза - Кэш догоняет веса при
B = байты весов / KV: при 8k это 15 последовательностей (неделя 9). Дальше шаг растёт почти линейно поB, а выдача упирается в потолокW / KV ≈ 3 120ток/с, сколько батч ни увеличивай. int8 для весов и кэша режет обе части вдвое: приB = 1шаг 2.6 мс, а в 80 ГБ влезает 134 последовательности по 8k вместо 59 - Цена токена. GPU оплачивают за час, а не за токены:
$ за 1M = цена часа / (ток/с · 3600) · 10⁶. При условных $3 за час H100:B = 1даёт $4.26 за миллион выходных токенов,B = 8$0.77,B = 32$0.39 - Язык издержек из микроэкономики. Обучение это постоянные и невозвратные издержки, инференс переменные: растут с числом
токенов. Внутри шага то же деление: чтение весов постоянная часть (4.79 мс на весь батч), кэш переменная (0.32 мс на каждого).
Средние издержки на токен
4.79/B + 0.32мс падают с батчем к предельным (цене ещё одного запроса, 0.32 мс): пол около $0.27 за миллион. Поэтому маленькую модель выгодно учить сверх Chinchilla (неделя 14): переменные издержки падают - Латентность против пропускной способности. TPOT пользователя равен шагу: 5.1 мс при
B = 1, 15.1 мс приB = 32. КаждыйBдаёт пару (TPOT, цена), и все эти пары лежат на фронте Парето (множестве вариантов, где улучшить одно можно только ухудшив другое): дешевле значит медленнее. Выбор делает требование к сервису. При TPOT не больше 10 мс берёмB = 16(9.9 мс, $0.52). Чату хватитB = 48: шаг 20.2 мс, 50 ток/с на человека, быстрее, чем он читает, и $0.35. Тот же фронт помогает выбирать между моделями: подробно в неделе 18 - Разложение инференса по GPU (в decode только тензорно, prefill на отдельных машинах): подробно в неделе 14
Типичные ошибки
- Забыть
offsetу RoPE при кэше, и все новые токены получат позицию 0. Ловятtest_rope_offset_matches_slicing,test_kv_cache_matches_full_forward(«если этот тест падает, обычно виноват offset у RoPE») is_causal=TrueприT = 1: маска SDPA выровнена к левому верхнему углу, и новый токен видит только первый ключ. Отсюдаis_causal=(T > 1)вAttention.forward; ловитtest_kv_cache_matches_full_forward- Сдвигать
cache.lengthвнутриupdateкаждого слоя, а не один раз за проход: позиции разъедутся. Ловитtest_kv_cache_matches_full_forward: тест сам вызываетadvanceпосле шага - При отказе сэмплировать из
pвместо остатка: переоценённые черновиком токены выходят чаще. Ловятtest_residual_zeroes_tokens_the_draft_overrated,test_output_distribution_equals_target_exactly - Оценивать шаг decode по FLOPs: при
B = 32арифметика занимает 0.49 мс из 15 мс, остальное чтение весов и кэша. Ловитtest_decode_step_llama3_h100_batch_32_numbers
Код → nanolm/speculative.py: residual_distribution, accept_or_resample,
speculative_generate. KV-кэш уже есть в modules.py: KVCache (update, advance, nbytes),
offset в Attention.forward; генерация с prefill и decode в NanoLM.generate. Метрики:
SpecDecodeStats.acceptance_rate и tokens_per_target_forward, база сравнения baseline_generate.
Задание в exercises/speculative.py: NANOLM_IMPL=exercises pytest tests/test_speculative.py -v.
Шаг и цена токена в nanolm/budget.py: decode_step_time, cost_per_million, critical_batch, kv_bytes_per_token,
железо H100 и A100; тесты в tests/test_budget.py. Упражнение: построй кривую «TPOT против $ за 1M» по B
от 1 до потолка памяти для своей модели и отметь точку, которую выбрал бы для чата и для агента с жёстким TPOT.
Код (глубина) → nanolm/mla.py: MLA с кэшем MLACache (на токен только латент c и общий k_rope); пути
naive_attention и absorbed_attention обязаны совпасть. Задание в exercises/mla.py:
NANOLM_IMPL=exercises pytest tests/test_mla.py -v. Сначала прочитай раздел про MLA в 05-ГЛУБИНА.
Главный тест недели test_output_distribution_equals_target_exactly:
60 000 сэмплов, эмпирическое распределение обязано сойтись к целевому.
Если сошлось, ты доказал кодом то, что до этого вывел на бумаге.
Задачи на салфетке. Решай без калькулятора, до порядка величины; ответы ниже. Модель на 13 млрд параметров
в bf16, 40 слоёв, GQA с 8 KV-головами, H = 128, одна H100 (80 ГБ, полоса 3.35 ТБ/с, то есть 3.35 ГБ/мс,
989 TFLOP/с); 6 ГБ памяти оставляем на активации и фрагментацию.
- Сколько весит KV-кэш на токен и на последовательность из 4 096 токенов?
- Какой максимальный батч при контексте 4k?
- Какой потолок скорости у одного пользователя?
- Сколько длится шаг decode при
B = 32и контексте 4k, сколько токенов в секунду он даёт и во что упирается? - При
B = 32что выгоднее: веса в int8 или кэш в int8? С какого батча кэш читается дольше весов?
Ответы. (1) 2·40·8·128·2 = 163 840 байт, 160 КиБ на токен; × 4 096 ≈ 0.67 ГБ на последовательность.
(2) Веса 26 ГБ, под кэш остаётся 80 − 26 − 6 = 48 ГБ, 48 / 0.67 ≈ 71.
(3) Один проход по весам 26 / 3.35 ≈ 7.8 мс, значит не больше 129 токенов в секунду.
(4) Кэш 32 · 0.67 ≈ 21.5 ГБ читается 6.4 мс; вместе с весами шаг 14.2 мс, 32 / 0.0142 ≈ 2 260 токенов в секунду.
Арифметика занимает 2·13·10⁹·32 / 989·10¹² ≈ 0.84 мс: шаг упирается в память.
(5) Веса в int8: (13 + 21.5) / 3.35 ≈ 10.3 мс; кэш в int8: (26 + 10.7) / 3.35 ≈ 11.0 мс, пока выигрывают веса.
Кэш перевешивает веса при B · 0.67 > 26, то есть с B ≈ 39; при длинном контексте порог ниже.
Математика (трек D): D13: reservoir sampling и доказательство по индукции; D14: точность speculative decoding и ожидаемое ускорение с учётом цены черновика.
Интервью-вопрос недели: «Сервис на 8B отвечает медленно. Что делаешь?» Структура на 3 минуты: разделить TTFT и TPOT → TTFT: очередь, длина промпта, prefix caching → TPOT: decode упирается в память, значит меньше байт (квантование весов и кэша, GQA) и больше токенов на чтение (continuous batching, speculative decoding) → потолок батча задаёт кэш (PagedAttention) → проверить качество после каждой меры.
Источники: Pope et al., Efficiently Scaling Transformer Inference (2022); Kwon et al., PagedAttention (2023); Yu et al., Orca (2022); Leviathan et al., Speculative Decoding (2022); Zheng et al., SGLang (2024), prefix caching.
Глубже: 05-ГЛУБИНА, разделы «★★ Неделя 11. Доказательство корректности speculative decoding» и «Неделя 11. Сжатие кэша и черновики: MLA, гибрид окон, MTP».
Результаты недели
- Могу объяснить через arithmetic intensity, почему prefill compute-bound, а decode memory-bound.
- Могу доказать на бумаге за 10 минут, что speculative decoding сэмплирует точно из целевого распределения.
- Могу реализовать
speculative_generate, проходящийtest_output_distribution_equals_target_exactly. - Могу посчитать максимальный батч при заданной памяти под KV-кэш.
- Могу оценить шаг decode и цену миллиона токенов на салфетке и объяснить, почему цена падает с батчем.
Самопроверка
- Почему continuous batching выигрывает у static на чат-нагрузке?
- Какую проблему памяти решает PagedAttention?
- От чего зависит ускорение speculative decoding и когда его нет?
- Во сколько раз GQA с
Kгруппами уменьшает кэш по сравнению с MHA и что ещё его сокращает? - Почему средняя цена токена падает с батчем и где у неё пол?