Неделя 9. Бухгалтерия: параметры, FLOPs, память
Учиться в приложении: тьютор, задачи с кодом →
Ядро: параметры по частям, 6N FLOPs, память обучения и инференса, размер KV-кэша · Глубина: точная память активаций, MFU и стоимость обучения, полные и активные параметры MoE · ≈ 11 ч ядро / 21 ч всё
Отдельная неделя, потому что это спрашивают почти всегда, а считают почти все плохо. Любое решение дальше начинается с этих формул: сколько GPU, какой батч, влезет ли контекст, окупится ли параллелизм (неделя 14). Их надо уметь вывести, а не вспомнить.
Шаг 1. Параметры
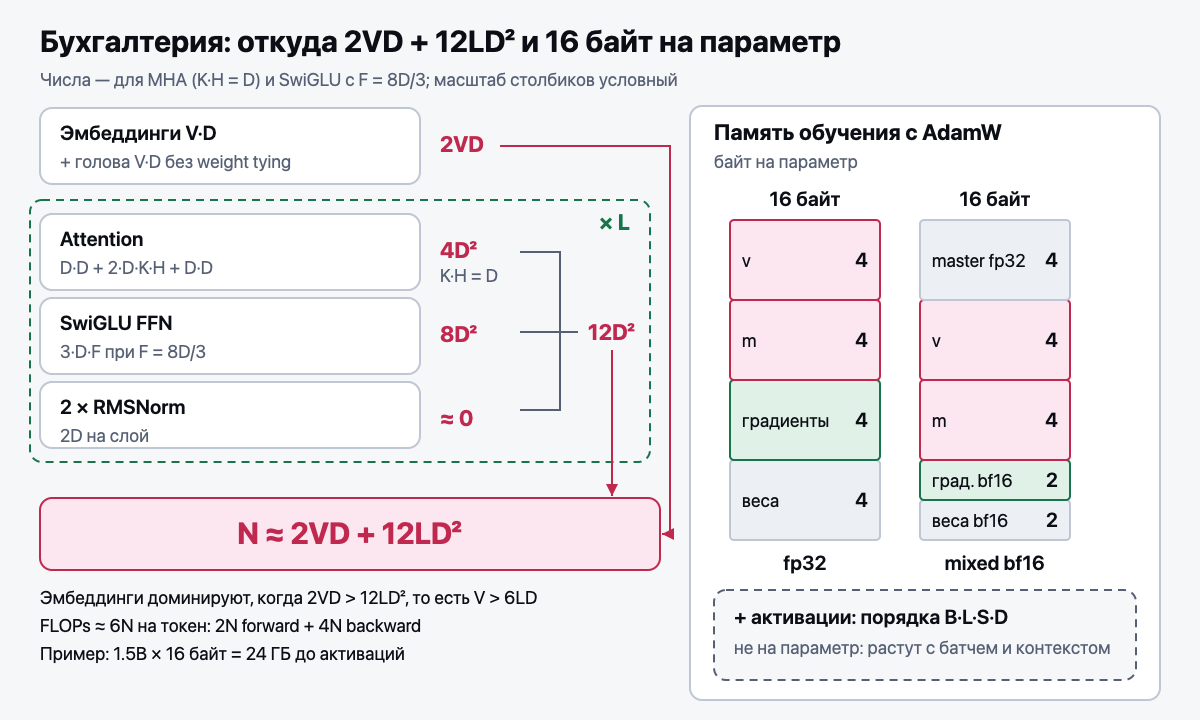
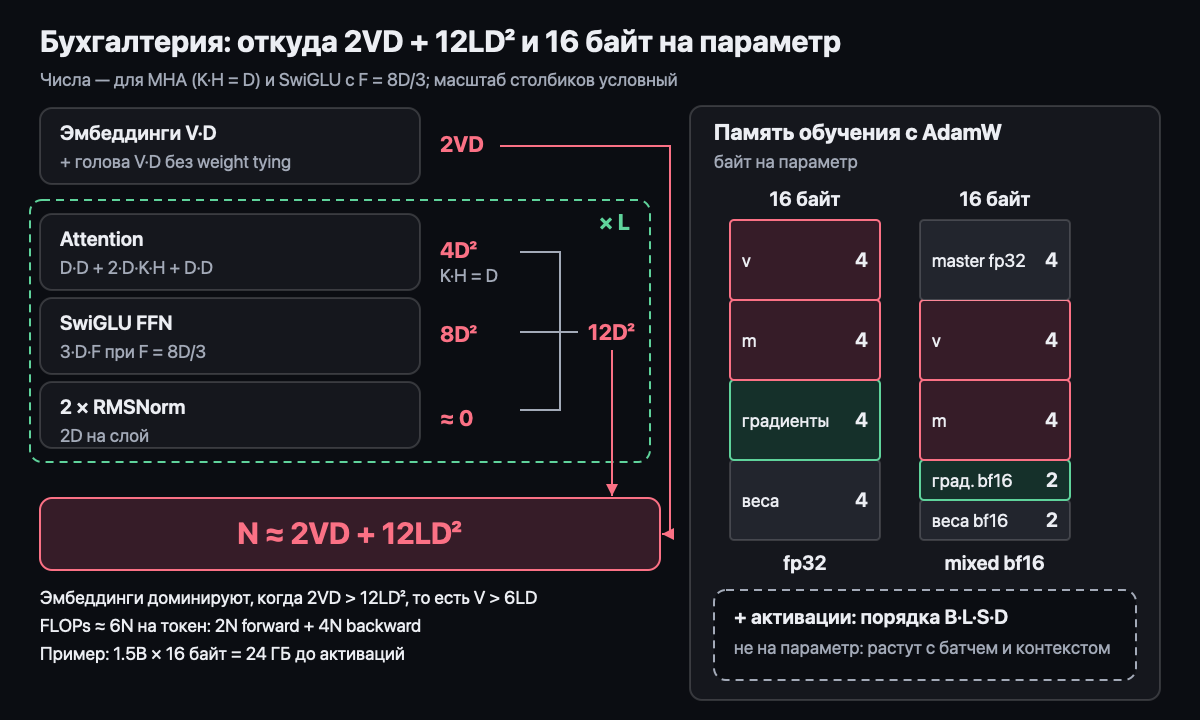
- Параметры по частям: эмбеддинги
V·D, attentionD·D + 2·D·K·H + D·D, FFN3·D·F, нормы. При MHA (K·H = D) внимание даёт4D², SwiGLU приF = 8D/3даёт3·D·8D/3 = 8D². На слой12D², плюс вход и голова2VD:N ≈ 2VD + 12LD²(нормы добавляют2Dна слой, их отбрасываем при округлении) - Проверка на Llama-3-8B: формула даёт
1.05B + 6.44B = 7.49B, а настоящих 8.03B. Разница честная: GQA сжимает внимание (1.34B вместо 2.15B), аF = 14336 = 3.5Dраздувает FFN (5.64B вместо 4.29B) - Эмбеддинги доминируют, когда
2VD > 12LD², то естьV > 6LD. У GPT-2 small это около трети параметров
Шаг 2. FLOPs
На пальцах. Каждый вес на каждом токене один раз умножается и один раз складывается,
то есть 2 операции. Обратный проход делает такую работу дважды: считает градиент по входу слоя,
чтобы передать его дальше назад, и градиент по самому весу. Итого 2 + 4 = 6 операций на вес на токен.
Модель на 1 млрд параметров, 20 млрд токенов: 6 · 10⁹ · 2·10¹⁰ = 1.2·10²⁰ FLOPs.
- FLOPs: forward ≈
2Nна токен, backward ≈4N, итого6Nна токен (N = число параметров). Основа простая: матмул(b×n)·(n×m)стоит2bnm. ВNне входят эмбеддинги: это выборка строки, а не умножение- Вклад attention
~4·B·N·S²·Hи когда он начинает доминировать над матмулами. ЭтоQKᵀиAVпо2·B·N·S²·Hна слой в forward. На токен с backward выходит12·L·S·D. Против6N ≈ 72LD²получаем порогS ≈ 6D; у Llama-3-8B (budget.py) это около 26.6k
- Вклад attention
- Голова
D×Vуже настоящий матмул, ещё6VDна токен. Вflops_per_tokenона учтена отдельной строкойlm_head: у Llama-3-8B это ~3.2 GFLOPs, около 6% итога - MoE: полные и активные параметры. В MoE-слое (mixture of experts, смесь экспертов, неделя 19) вместо одного FFN
стоят
Eэкспертов, а роутер отправляет каждый токен вkиз них. На пальцах. 24 слоя, в каждом внимание на 20M и 8 экспертов по 60M, top-2. Полных параметров24·(20 + 8·60)M = 12.0B, активных на токен24·(20 + 2·60)M = 3.36B. FLOPs считают по активным:6 · 3.36·10⁹ ≈ 2·10¹⁰на токен при обучении. Память считают по полным: 24 ГБ весов в bf16, 192 ГБ при 16 байтах AdamW. В decode при большом батче токены расходятся по всем экспертам: шаг читает все 12B, а считает как 3.36B. Поэтому критический батч (неделя 13) у MoE выше примерно в12 / 3.36 ≈ 3.6раза. У DeepSeek-V3 полных параметров 671B, активных 37B: память как у гиганта, арифметика как у средней модели
Шаг 3. Память
На пальцах. У каждого параметра при обучении с AdamW пять «карточек»: вес в bf16 (2 байта), градиент в bf16 (2), точная копия веса в fp32 (4) и два момента Adam в fp32 (4 + 4). Итого 16 байт. Модель на 7 млрд занимает 112 ГБ ещё до активаций: на одну H100 с 80 ГБ она уже не влезает.
- Активации: что хранится для backward, откуда берётся
O(B·L·S·D). Каждый матмул хранит свой вход, SwiGLU хранит промежуточныеB·S·F, наивное внимание ещё и матрицуB·N·S²(формула есть в05-ГЛУБИНА). У Llama-3-8B при батче 8 × 8192 это 384 GiB против 120 GiB на состояния. Лечат checkpointing (неделя 2) и микробатчами - Память обучения: параметры + градиенты + состояния Adam (m, v) + активации.
Для fp32 AdamW это 16 байт на параметр; для mixed precision надо считать аккуратно:
2 + 2 + 4 + 4 + 4, снова 16. Экономия mixed precision в активациях и скорости, а не в состояниях - Память инференса: веса + KV-кэш =
2 · B · S · L · K · H · bytes. Вывод: на каждый токен в каждом слое хранится ключ и значение (2), в каждом поKголов размераH. Llama-3-8B, bf16: 128 КиБ на токен, 1 GiB на 8k контекста; при MHA было бы 4 GiB - Вклад KV-кэша. Веса от батча не зависят, кэш растёт с ним линейно. Кэш сравняется с весами при
B = байты весов / (S · 2 · L · K · H · bytes). У Llama-3-8B при 8k это16.06 ГБ / 1.07 ГБ ≈ 15последовательностей, при 4k около 30. Дальше главный потребитель и памяти, и времени шага уже кэш: decode читает его целиком на каждом новом токене (неделя 11,decode_step_time) - MFU (model FLOPs utilization), мера эффективности обучения: доля пика, которую дают
полезные FLOPs (
6Nи внимание на токен × токены в секунду). Пересчёт при checkpointing не засчитывается. Хорошо настроенное обучение даёт 35–50%;training_timeпо умолчанию берёт 45%
Типичные ошибки
- Считать KV-кэш по
NвместоK: ловитtest_gqa_saves_kv_cache_exactly_N_over_K. Забыть двойку за K и V: ловятtest_kv_cache_formula,test_kv_cache_size_formula - Включить эмбеддинги в
6N: ловитtest_flops_rule_of_6N. ВзятьF = 4Dу SwiGLU: ловитtest_swiglu_ffn_dim_is_8D_over_3 - Посчитать связанные эмбеддинги дважды (
tie_embeddingsвSpec); путать GB и GiB (разница 7%, тест не поймает) - У MoE считать
6Nпо полным параметрам, а память по активным. Надо наоборот: FLOPs по активным, память по полным
Код → nanolm/budget.py: калькулятор: на вход конфиг модели и железо (Spec), на выход
parameter_breakdown, flops_per_token, training_memory, inference_memory, training_time, report.
Запуск: python -m nanolm.budget --V 128256 --D 4096 --L 32 --N 32 --K 8 --S 8192 --F 14336,
тесты: pytest tests/test_budget.py -v (ключевой из них test_llama3_8b_parameter_count). В модели то же
считают NanoLM.num_parameters, flops_per_token, kv_cache_bytes. Проверить предсказания измерением
через torch.cuda.max_memory_allocated() (на Mac через torch.mps.current_allocated_memory()).
Математика (трек D): D9: оценка времени обучения 7B по 6N, MFU и числу GPU;
D10: Стирлинг и оценки порядков с большими числами.
Интервью-вопрос недели: «Влезет ли полное дообучение 7B на одну H100 на 80 ГБ?» Структура на 3 минуты: 16 байт на параметр → 112 ГБ состояний, нет → что шардировать (ZeRO/FSDP, неделя 14) → что сжать (8-битные моменты Adam) → активации: checkpointing, микробатч → альтернатива: LoRA (неделя 15).
Источники: Kaplan et al., Scaling Laws (2020), откуда 6N; Korthikanti et al., *Reducing Activation
Recomputation* (2022); Chowdhery et al., PaLM (2022), откуда MFU; Pope et al., *Efficiently Scaling Transformer
Inference* (2022), где так же считают память и время инференса; DeepSeek-V3 (2024), полные и активные параметры MoE.
Глубже: 05-ГЛУБИНА, раздел «Неделя 9. Бухгалтерия: точные формулы вместо «примерно»».
Результаты недели
- Могу вывести
N ≈ 2VD + 12LD²(для MHA) из суммы по компонентам и назвать, когда эмбеддинги доминируют. - Могу за 5 минут оценить время обучения по
6Nна токен, числу токенов и пиковым FLOPs с учётом MFU. - Могу посчитать KV-кэш для заданной модели, батча и контекста и батч, при котором он догоняет веса.
- Могу развести полные и активные параметры MoE: что из них идёт в FLOPs, а что в память.
- Могу написать калькулятор
budget.pyи подтвердить прогноз памяти измерением. - Могу объяснить, почему формула даёт 7.5B для Llama-3-8B, а настоящих параметров 8.03B.
Самопроверка
- Откуда в
6Nдвойка и откуда четвёрка? - При какой длине контекста внимание начинает доминировать над матмулами и почему?
- Из чего складываются 16 байт на параметр при AdamW в fp32 и что меняется при mixed precision?