Неделя 21. Продакшн-LLM: RAG, агенты, оценка
Учиться в приложении: тьютор, задачи с кодом →
Ядро: BM25, плотный поиск и RRF, раздельная оценка RAG, цикл агента и prompt injection, первый ML system design · Глубина: виды памяти агента, своя обвязка агента, подгонка под оценку, теория игр (05-ГЛУБИНА) · ≈ 13 ч ядро / 25 ч всё
Неделя, на которой курс становится продуктом: AI-тьютор в tutor-api/ построен
ровно из того, что здесь разбирается. Главная мысль: **качество LLM-приложения
определяется не столько моделью, сколько тем, что попадает в контекст, и тем,
как это измеряется.**
Часть 1. Retrieval
На пальцах. Три документа. D1: «RMSNorm делит вектор на его среднеквадратичное значение». D2: «LayerNorm вычитает среднее и делит на стандартное отклонение». D3: «KV-кэш хранит ключи и значения прошлых токенов». Вопрос: «Чем RMSNorm отличается от LayerNorm?». Поиск по словам находит D1 (есть «RMSNorm») и D2 (есть «LayerNorm»), а D3 не находит. D1 и D2 вставляются в промпт перед вопросом, и модель отвечает по ним, а не по памяти. Если бы поиск вернул D3, модель ответила бы по памяти или выдумала. По одному ответу тогда не понять, виноват поиск или генерация. Отсюда раздельная оценка в части 2.
На пальцах. Слагаемое частоты в BM25 при k₁ = 1.2 (без учёта длины): слово встретилось 1 раз: 1.0,
2 раза: 1.375, 10 раз: 1.96. Потолок k₁ + 1 = 2.2, сколько ни повторяй.
Поэтому спам, где «RMSNorm» повторено сто раз, наберёт по этому слову меньше 2.2.
А документ, где «RMSNorm» встречается дважды и «LayerNorm» один раз, при равных IDF наберёт 1.375 + 1.0 = 2.375.
- Retrieval, то есть поиск фрагментов, которые кладут в контекст модели
- BM25:
Σ_{t∈q} IDF(t) · f(t,d)(k₁+1) / (f(t,d) + k₁(1 − b + b·|d|/avgdl)). Разобрать каждый член: IDF (логарифм обратной доли документов, где есть слово): редкое слово информативнее;k₁отвечает за насыщение (десять повторов слова не в десять раз лучше одного);bза нормировку по длине (в длинном документе слово встречается и случайно) - Плотный поиск: bi-encoder (вопрос и документ кодируются в векторы отдельно): документы кодируются заранее, поиск дешёвый; cross-encoder (вопрос и документ подаются в модель вместе): точнее, но прогон на каждую пару. Отсюда каскад: дешёвый recall → дорогой rerank
- BM25 выигрывает на точных терминах, именах, редких словах («SwiGLU»), плотный выигрывает на перефразах. Вывод: они ошибаются на разных запросах, поэтому гибрид
На пальцах. BM25 ставит D1 первым, D2 вторым; плотный поиск ставит D2 первым, D1 третьим. При k = 60
D1 получает 1/61 + 1/63 ≈ 0.03227, D2 получает 1/62 + 1/61 ≈ 0.03252.
D2 побеждает: он высоко у обоих, а D1 только у одного. Складывать скоры BM25 и косинусы при этом не пришлось.
- RRF (Reciprocal Rank Fusion, слияние списков по рангам):
score(d) = Σ_r 1/(k + rank_r(d)),k ≈ 60. Почему ранги, а не скоры: шкалы BM25 и косинуса несравнимы, их нормировка хрупка, а ранги сравнимы всегда - Чанкинг (нарезка документов на куски, которые и становятся единицами поиска) всегда компромисс: мелкий чанк точнее находится, но теряет контекст. Резать по структуре документа (заголовки) обычно лучше, чем фиксированным окном
Часть 2. Оценка RAG
- Оценивать retrieval и генерацию раздельно: recall@k (доля вопросов, где нужный фрагмент в первых
k) и MRR (среднее1/рангпервого нужного фрагмента) отвечают, был ли нужный фрагмент найден; faithfulness (ответ опирается на найденное, а не выдуман) и корректность отвечают, как им распорядилась модель. Без разделения не понять, где ошибка - Золотой набор: 50–100 вопросов с отмеченными правильными фрагментами. Каждая правка промпта или индекса означает прогон набора до и после и сравнение статистикой недели 18: McNemar на одних и тех же вопросах, bootstrap-интервал для разницы recall@k
Часть 3. Агенты
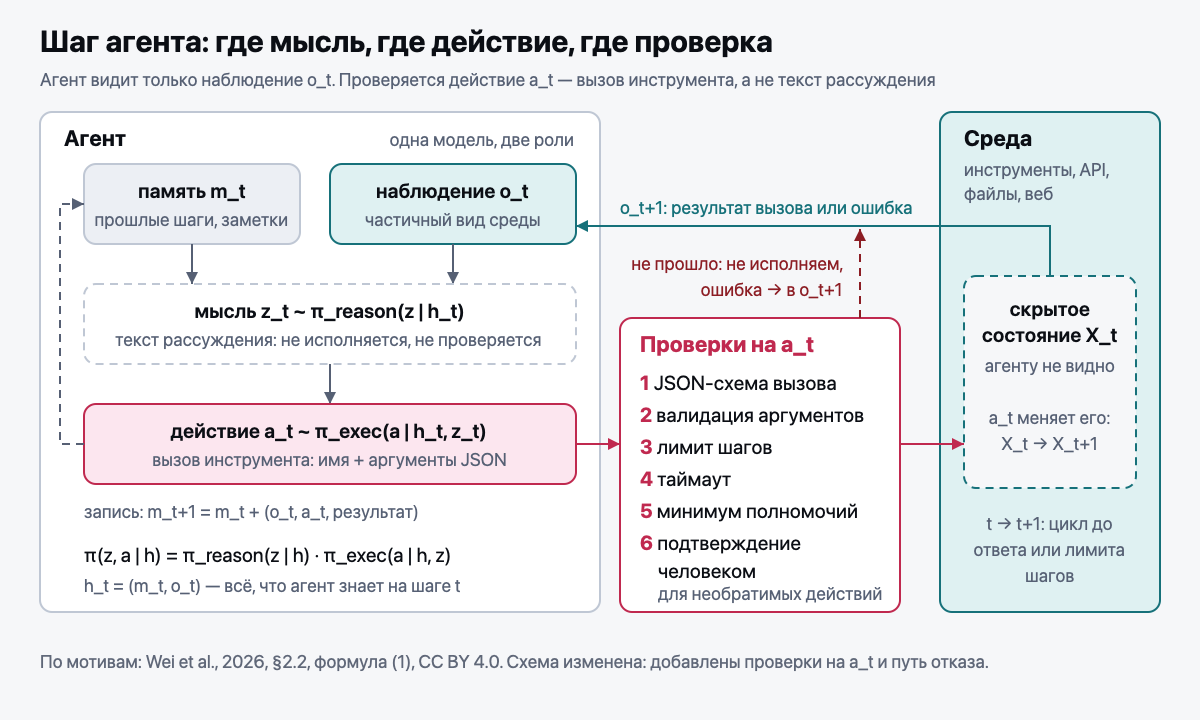
На пальцах. Задача агента: «удали временные файлы проекта». Рассуждение безупречно:
«временные файлы лежат в ./tmp, удалю только их». А вызов инструмента такой:
delete(path="/home/user", recursive=true). Проверка текста рассуждения ничего бы не нашла.
Проверка аргументов («путь обязан быть внутри ./tmp») ловит ошибку до исполнения,
и отказ возвращается агенту как наблюдение.
Четыре уточнения по свежему обзору агентного рассуждения (Wei et al., 2026, 29 авторов, принят в TMLR; лицензия CC BY 4.0, схемы можно перерисовывать с атрибуцией):
- Мысль и действие не одно и то же. Проверять и логировать нужно *аргументы вызова инструмента*, а не текст рассуждения: рассуждение может быть убедительным при неверном вызове.
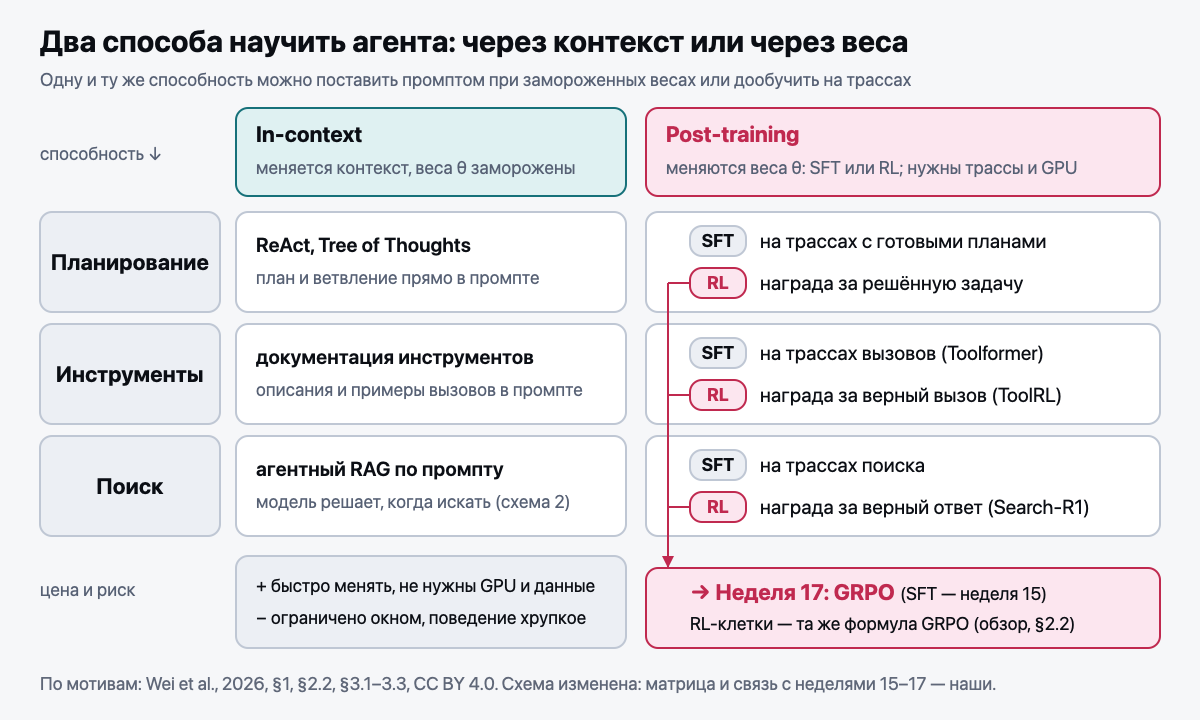
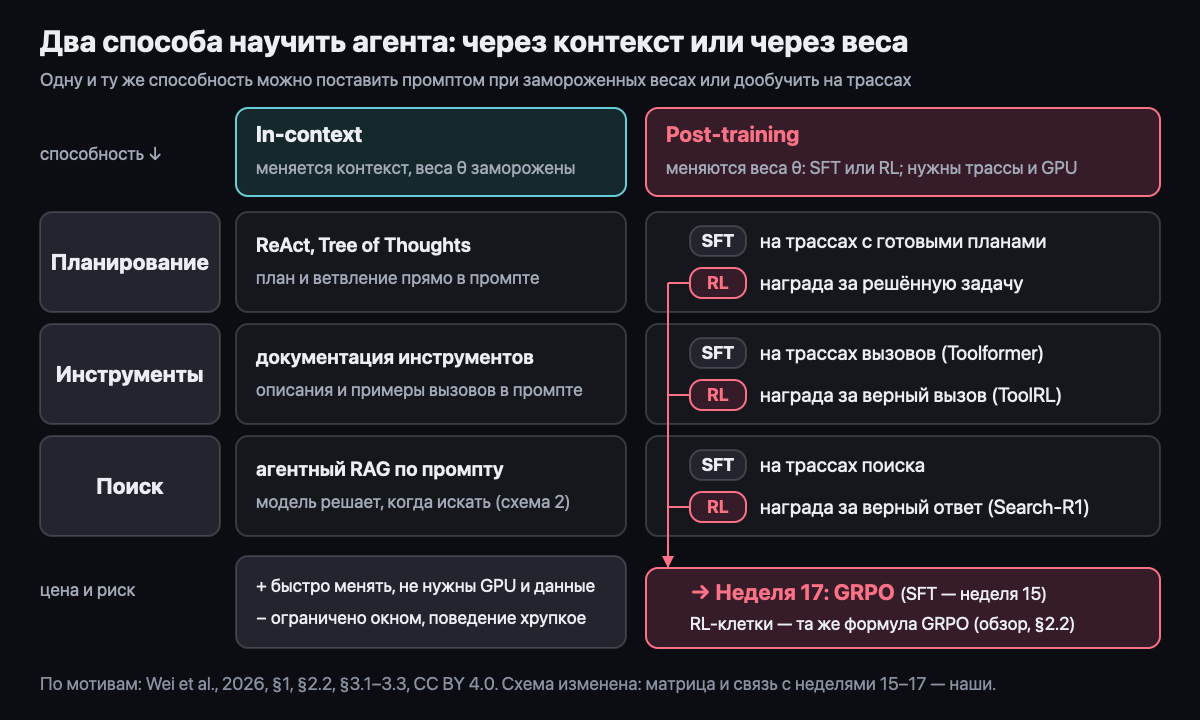
- Умение пользоваться инструментами даётся не только промптом. Его можно дообучить (SFT на трассах вызовов или RL с наградой за успех задачи). Это прямой мост к неделе 17 (Toolformer, 2023, первая работа этой линии).
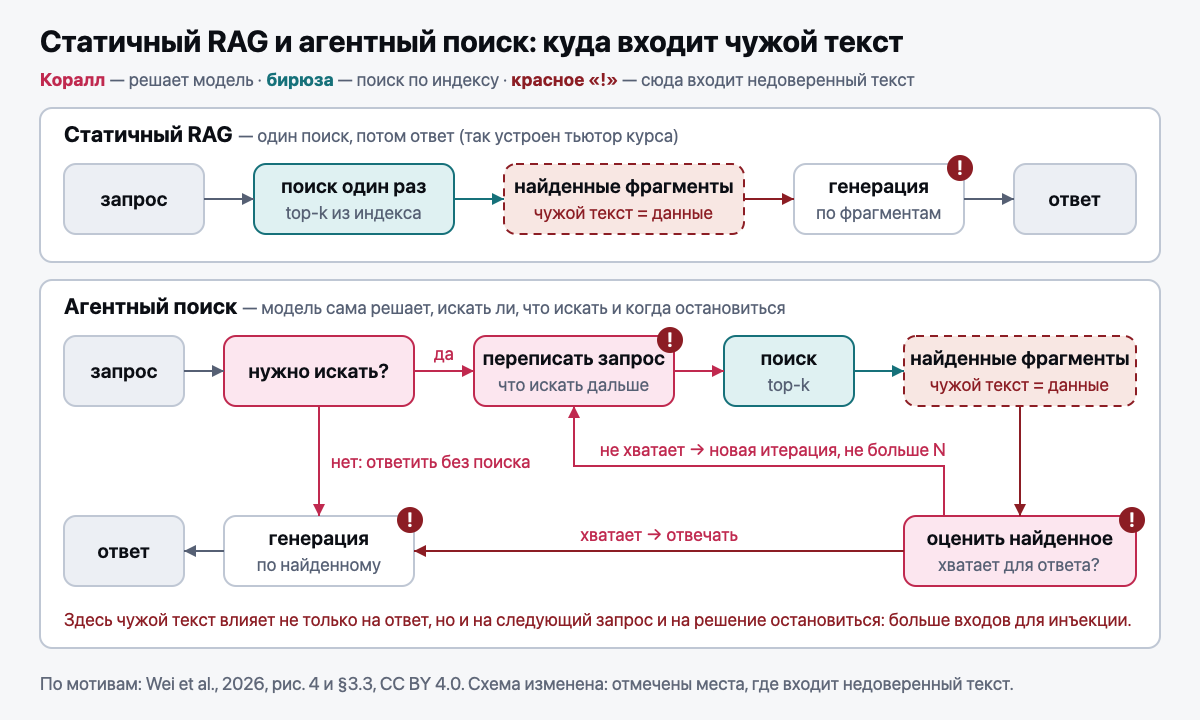
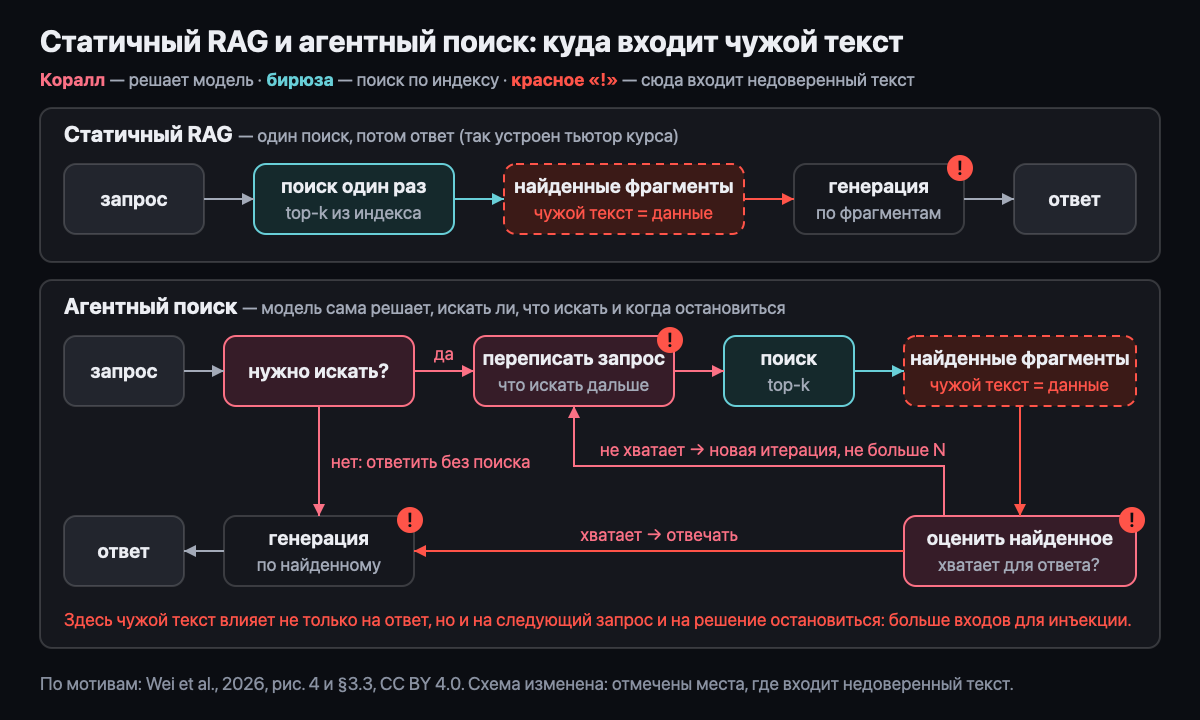
- Поиск бывает статичным и агентным. Статичный RAG: один запрос → фрагменты → ответ. Агентный: модель сама решает, что искать, переформулирует и останавливается. Тьютор курса статичный; переход к агентному оставлен как упражнение недели. Агентному поиску тоже учат через RL с наградой за верный итоговый ответ (Search-R1, 2025).
- Память входит в состояние агента, а не в «ещё один контекст»: что сохранять между шагами, что между сессиями, и как это влияет на воспроизводимость.
Три вида памяти агента
На пальцах. Агент-помощник ведёт расписание студента. Просьба: «перенеси завтрашнюю консультацию на пятницу».
Рабочая память на этом шаге: сама просьба, ответ calendar.list(date="завтра") (одна встреча в 15:00)
и прошлый шаг, всего около 2 тыс. токенов; после сессии от неё ничего не останется.
Внешняя память: 500 заметок о пользователе в базе, из них в контекст попадают 3, найденные поиском по слову
«консультация», и одна из них «по пятницам после 16:00 встреч не ставить».
Процедурная память: навык «перенос встречи», записанный как инструкция (проверить конфликты → предложить два слота →
дождаться подтверждения → вызвать calendar.move); он не про этого пользователя, а про то, как делать.
Сбой в каждой памяти выглядит по-своему: агент забыл условие из начала длинного диалога (рабочую память сжали),
поставил встречу на пятницу в 17:00 (поиск не нашёл заметку), перенёс без подтверждения (навык не подгрузился).
- Рабочая память (всё, что лежит в контексте на текущем шаге): точная и быстрая, но ограничена окном и оплачивается токенами на каждом шаге. При переполнении её сжимают, как в лабе ниже
- Внешняя память (хранилище вне модели, из которого нужное достают поиском или запросом к базе): по сути RAG над собственной историей агента, поэтому к ней применимы recall@k и раздельная оценка из части 2. Новый риск в записи: что агент сохранил, то позже прочтёт как факт. Текст из инструментов, попавший в память, остаётся данными, а не инструкциями (часть 4)
- Процедурная память (выученные навыки: инструкции, шаблоны, проверенные функции, которые агент применяет к новым задачам): её держат в промпте (in-context) или переносят в веса дообучением на удачных траекториях (post-training, схема 3). Промежуточный вариант дал Reflexion (Shinn et al., 2023): после неудачной попытки агент записывает словесный вывод о своей ошибке и читает его в следующей попытке, веса не меняются
- Внешняя и процедурная память меняются между запусками. Поэтому в лог прогона пишут их версию (снимок базы, хэш набора навыков), иначе два прогона одного агента нельзя честно сравнить
В обзоре нет ни MCP, ни prompt injection, поэтому по безопасности опора остаётся на OWASP.
- Tool use: модель выдаёт вызов по JSON-схеме, код исполняет его и возвращает результат в контекст. Цикл «рассуждение → действие → наблюдение» (ReAct). MCP (Model Context Protocol) это открытый протокол подключения инструментов
- Инженерия важнее промпта: лимит шагов, таймауты, идемпотентность (повторный вызов не меняет результат), валидация аргументов, минимальные полномочия. Если шаги известны заранее, нужен конвейер, а не агент
- Несколько агентов с разными наградами играют в игру. Два агента делят лимит API: оба экономят, у каждого 4; один хватает: 6 против 1; оба хватают: по 2. Хватать выгоднее при любом ходе соседа, и оба приходят к (2, 2), хотя (4, 4) лучше. Это равновесие Нэша (никому не выгодно отклониться в одиночку): без общих правил агенты скатываются в него. Дебаты двух моделей перед судьёй (Irving et al., 2018) задуманы как игра с нулевой суммой, где в равновесии выгодно говорить правду; это гипотеза, её проверяют экспериментом
Лаба. Свой harness (обвязка агента)
На пальцах. Агент решает задачу в 80% запусков. Метрика pass@3 (хотя бы один успех из трёх попыток)
равна 1 − 0.2³ = 0.992, и агент выглядит почти идеальным. Но пользователь запускает агента один раз и ждёт,
что тот сработает каждый раз. Надёжность pass^3 (успех во всех трёх попытках) равна 0.8³ = 0.512.
Модель та же, а число 99% или 51% в зависимости от того, что считаем.
- Цикл на 50–80 строк без фреймворка: модель выдаёт вызов инструмента или финальный ответ, код исполняет вызов и возвращает результат как наблюдение; лимит шагов и лимит токенов контекста
- Ошибка инструмента (исключение, таймаут, неизвестное имя, неверные аргументы) не роняет цикл, а возвращается модели наблюдением с текстом ошибки: так модель может исправиться
- Сжатие контекста: когда история не помещается в бюджет, старые наблюдения заменяются кратким итогом, а постановка задачи и последний шаг остаются дословно
- В тестах модель заменяют записанной последовательностью действий: цикл проверяется детерминированно и без API. В тренажёре есть задача «Цикл агента с инструментами» ровно в таком виде: с неё удобно начать лабу
- Оценка: 20–50 задач с проверяемым итогом (тест проходит, файл в нужном состоянии), по 5 прогонов на задачу; доля успехов, pass^k, среднее число шагов и токенов. Траектории успешных прогонов становятся данными для SFT (неделя 15), а проверяемый итог становится наградой для GRPO (неделя 17)
Подгонка под собственную оценку. На пальцах. Набор из 30 задач, десять правок промпта подряд, каждую оставляем, если доля успехов выросла. На этих 30 задачах доля поднялась с 60% до 80%, а на 20 отложенных так и осталась 60%: правки выучили особенности конкретных задач, а не сделали агента лучше. Опаснее, когда обвязку правит сам агент в цикле «изменил → прогнал оценку → оставил, если выросло»: число можно поднять, ничего не улучшив, например запомнить ответ на знакомую задачу или дать агенту инструмент, через который виден эталон. Это закон Гудхарта (метрика, ставшая целью, перестаёт измерять) в миниатюре. Защита простая: подбирать на одной части набора, отчитываться на замороженной другой и смотреть, растут ли обе; держать эталонные ответы там, куда агент не может дотянуться ни одним инструментом; читать траектории, а не только итоговое число. Как такой цикл устроен на практике: Lance Martin, автоматическое построение оценок и hill-climbing (claude.dev, 2026).
Часть 4. Стоимость, безопасность, serving
- Кэширование промпта: стабильное (системный промпт, документы) кладут в начало, изменчивое в конец, иначе кэш не срабатывает
- Prompt injection: текст из retrieval и инструментов это данные, а не инструкции. Косвенная инъекция через документ остаётся главным риском RAG
- Serving: vLLM и SGLang с их PagedAttention, continuous batching, prefix caching (неделя 11)
Часть 5. Первая задача ML system design
Всё, что выше, собирается в раунд, где просят спроектировать систему целиком (формат и рубрика: РУБРИКИ.md, раздел 7). Разбери вслух за 45 минут постановку «ассистент по 10 000 внутренних документов с правами доступа» по шагам: требования → оценка на салфетке → архитектура → данные → оценка качества → serving → отказы. Опора: тьютор курса устроен так же, и почти каждое его решение (гибридный поиск, золотой набор, защита от инъекций) разобрано на этой неделе. В тренажёре есть задачи про BM25 и RRF: это ядро поиска, которое в system design рисуют одним квадратом, и полезно помнить, что внутри. Остальные постановки в разделе 8 банка вопросов.
Код → nanolm/retrieval.py: BM25 с нуля (токенизация, IDF, k₁, b);
CharNgramEncoder, векторный поиск по символьным n-граммам вместо нейросетевого
энкодера (семантики нет, зато устойчив к словоформам и ошибается не там, где BM25);
reciprocal_rank_fusion, HybridRetriever, recall_at_k. python -m nanolm.retrieval печатает
recall@k трёх методов на встроенном наборе. Задание в exercises/retrieval.py,
проверка: NANOLM_IMPL=exercises pytest tests/test_retrieval.py -v.
Живой пример лежит в tutor-api/src/retrieval.ts: прочитать, как устроен поиск
тьютора, и сравнить со своей реализацией. Практика: 30 вопросов по PROGRAM/*.md
с разметкой правильного раздела, recall@5 для BM25, плотного и гибрида в одной таблице.
Математика (трек D): D33: задача о секретаре; D34: Монти Холл на n дверей.
Интервью-вопрос недели: «RAG-система отвечает неправильно. Как найдёшь причину?» Структура: (1) разделить: был ли нужный фрагмент в контексте; (2) если нет, то recall@k на золотом наборе, чанкинг, гибрид, переписывание запроса; (3) если был, то позиция в контексте, конфликт с параметрическим знанием, промпт; (4) закрепить случай как регрессионный тест; (5) показать метрики до и после.
Источники: Robertson & Zaragoza, The Probabilistic Relevance Framework: BM25 and Beyond (2009); Cormack et al., Reciprocal Rank Fusion (2009); Lewis et al., Retrieval-Augmented Generation (2020); Yao et al., ReAct (2022); Schick et al., Toolformer: Language Models Can Teach Themselves to Use Tools (2023); Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning (2023); Jin et al., Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning (2025); Wei et al., A Survey of Agentic Reasoning for Large Language Models (2026), §2.2, §3.2–3.3, §4.2 как карта области.
Глубже: 05-ГЛУБИНА, раздел «Недели 17 и 21. Немного теории игр».
Результаты недели
- Могу реализовать BM25 с нуля и объяснить роль IDF,
k₁иbна конкретном примере. - Могу собрать гибридный поиск через RRF и объяснить, почему сливают ранги, а не скоры.
- Могу построить золотой набор и посчитать recall@k для трёх ретриверов.
- Могу за 5 минут разобрать ошибку RAG-системы, отделив сбой поиска от сбоя генерации.
- Могу написать цикл агента с обработкой ошибок инструментов и объяснить разницу между pass@k и pass^k.
- Могу различить рабочую, внешнюю и процедурную память агента и по симптому сбоя назвать, в какой из них искать причину.
- Могу за 45 минут спроектировать RAG-систему по шагам от требований до отказов, опираясь на числа.
Самопроверка
- Зачем в BM25 насыщение по частоте и нормировка по длине документа?
- Когда BM25 обыгрывает плотный поиск и когда наоборот? По примеру на каждый случай.
- Что такое косвенная prompt injection и как защитить от неё тьютора?
- Агент забыл ограничение, которое пользователь назвал месяц назад. В какой из трёх видов памяти искать причину и как это проверить числом?
- После десяти правок промпта доля успехов агента на твоём наборе выросла с 60% до 80%, а пользователи разницы не заметили. Что пошло не так и как поменять процедуру?
Mock-интервью недели (5 и 6 из 12). (5) ML system design, сессия D: постановка из раздела 8 банка вопросов, но не та, что разобрана в части 5. (6) ML coding, сессия B: beam search с пустого файла.